Pakiet umów albo instrukcję obsługi można wysłać modelowi językowemu w jednym zapytaniu, tak że odpowiedź opiera się na całym tekście i nikt nie musi najpierw budować wyszukiwarki w dokumentach. Qwen3.8-27B przyjmuje w jednym zapytaniu do 262 144 tokenów, czyli mniej więcej cały pierwszy tom „Lalki” Bolesława Prusa. Na jednej karcie graficznej H200 zaczął odpowiadać na pytanie o ten tom po 52 sekundach, a na kolejne pytanie o ten sam tekst po 1,3 sekundy. Jak długo zespół będzie czekał, zależy od tego, jak wysyła pytania.
Ten poradnik pokazuje, jak długo Qwen3.8-27B odpowiada na pytania o długie dokumenty, jak pewnie znajduje to, co w nich jest, i ile kosztuje każde pytanie, na podstawie naszych pomiarów po polsku i po angielsku. Najważniejsze wnioski:
- pierwsza odpowiedź przyszła po 17-18 sekundach przy dokumencie ze 131 tys. tokenów i po 52-55 sekundach przy 260 tys., więc dwa razy dłuższy tekst oznaczał mniej więcej trzy razy dłuższe czekanie;
- odpowiedzi na kolejne pytania o ten sam dokument przychodziły po 0,6-1,6 sekundy, z jednym wyjątkiem, bo serwer zachowuje to, co już przeczytał;
- model znalazł każdy fakt, który wstawiliśmy do powieści i w podręczniku firmy, a gdy faktu nie było, mówił o tym;
- każde pytanie o dokument z 260 tys. tokenów kosztuje około 0,05 USD przy cenie 0,20 USD za milion tokenów wejścia, bo każde pytanie wysyła cały dokument od nowa;
- długi dokument spowalnia inne zapytania na tej samej karcie graficznej, a jedno ustawienie dzieli kartę między nie.
Te liczby pochodzą z naszych własnych pomiarów na jednej karcie: każdą długość zmierzyliśmy raz dla każdego tekstu i języka, na dwóch tekstach, pytaniami o jeden konkretny fakt, a na karcie działały czasem inne zapytania. Pokazują, jak wygląda praca z modelem, ile trwa czekanie i ile oszczędza to, że serwer pamięta przeczytany tekst, ale nie są dokładnymi wartościami. Wiarygodne liczby wymagałyby benchmarku: wielu powtórzeń każdego ustawienia, większej liczby rodzajów dokumentów i pytań oraz innych kart i obciążeń.
Piszemy dla programistów, którzy decydują, czy wysyłać modelowi całe dokumenty, czy najpierw je przeszukiwać, dla zespołów, które uruchamiają Qwen3.8-27B na własnej karcie, i dla tych, którzy korzystają z niego przez Blixild AI. O dokumentach do 32 tys. tokenów i mniejszym modelu piszemy w poradniku o Bieliku. Kolejne sekcje omawiają: co mieści się w jednym zapytaniu, jak pewnie model znajduje fakt, jak czekanie rośnie z długością tekstu, ile kosztują kolejne pytania w czasie i w pieniądzach, własny serwer i pierwsze kroki.
Okno kontekstowe Qwen3.8-27B mieści 262 144 tokeny
Qwen3.8-27B to otwarty model zespołu Qwen, opublikowany na licencji Apache 2.0. Blixild AI udostępnia przez API jego wersję FP8, w której większość wag zajmuje po jednym bajcie. Jedno zapytanie mieści do 262 144 tokenów, czyli całe okno kontekstowe modelu, a do tego limitu liczą się pytanie, dokument i odpowiedź. Pierwszy tom „Lalki”, 123 tys. słów, to 261 tys. tokenów, około 2,1 tokena na słowo; tekst angielski zajmuje mniej, około 1,4 tokena na słowo w „Dumie i uprzedzeniu” Jane Austen. Tekst pełen liczb zajmuje więcej: nasz testowy podręcznik około 1,7 tokena na słowo po angielsku i 2,3 po polsku.
Qwen3.8-27B przed każdą odpowiedzią rozumuje, jeśli się tego nie wyłączy, a to kosztuje czas i tokeny przy pytaniu, które tylko wyszukuje coś w tekście. Rozumowanie wyłącza jedno pole; tak wykonaliśmy wszystkie opisane niżej pomiary:
curl https://api.blixild.com/v1/chat/completions \
  -H "Authorization: Bearer $BLIXILD_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "qwen3.8-27b",
       "chat_template_kwargs": {"enable_thinking": false},
       "messages": [{"role": "user", "content":
         "Dokument:\n\n§ 12. Umowę na serwis agregatu prądotwórczego podpisano z firmą Voltaris pod numerem VLT-2291.\n\nPytanie: Pod jakim numerem podpisano umowę na serwis agregatu prądotwórczego? Odpowiedz krótko, tylko na podstawie dokumentu. Jeśli dokument tego nie podaje, napisz, że tego w nim nie ma."}]}'
W praktyce zamiast jednozdaniowego paragrafu wstawia się cały dokument, wczytany z pliku przez program, który wysyła zapytanie. Pozostaje pytanie, jak dobrze model wykorzystuje całą tę długość.
Qwen3.8-27B znajduje fakt na początku, w środku i na końcu długiego dokumentu
Długi prompt ma sens tylko wtedy, gdy model czyta go w całości, także w środku. Sprawdziliśmy to na „Lalce” przyciętej do około 4 tys., 130 tys. i 258 tys. tokenów oraz na wygenerowanym podręczniku firmy, pełnym podobnych do siebie numerów inwentarzowych i numerów umów, o zbliżonych długościach, po angielsku i po polsku. W każdy tekst wstawiliśmy trzy zmyślone zdania, na 10, 50 i 90% jego długości, na przykład numer inwentarzowy zabytkowego zegara, żeby model nie mógł odpowiedzieć na podstawie tego, czego nauczył się o powieści. O każde z nich pytaliśmy w osobnym zapytaniu, a czwarte pytanie dotyczyło przedmiotu, o którym tekst nie wspomina.
Qwen3.8-27B znalazł wszystkie 27 wstawionych faktów i podał każdy dokładnie, na przykład numer zegara INW-4817. Na każde z dziewięciu pytań o brakujący przedmiot odpowiedział, że dokument tego nie podaje, zamiast podsunąć numer z sąsiedniego fragmentu. Test obejmuje tylko wyszukiwanie: jeden fakt na pytanie, jeden przebieg na długość, bez streszczeń i obliczeń na całym dokumencie. Ograniczeniem w tym teście nie było znalezienie faktu, tylko czas potrzebny, żeby go znaleźć.
Czas do pierwszego tokena rośnie szybciej niż dokument
Zanim model napisze pierwsze słowo odpowiedzi, czyta cały prompt, więc czas do pierwszego tokena, czyli czekanie na początek odpowiedzi, rośnie razem z dokumentem. Zmierzyliśmy go na samej karcie graficznej, bez sieci po drodze: 0,2-0,3 sekundy przy 4 tys. tokenów, 17-18 sekund przy 131 tys. i 52-55 sekund przy 260 tys. Dwa razy dłuższy dokument oznaczał mniej więcej trzy razy dłuższe czekanie. Gdy odpowiedź już się zaczęła, krótka odpowiedź z kilku słów była gotowa w ciągu jednej dziesiątej sekundy; przy krótkich promptach model pisze około 164 tokenów na sekundę po polsku i 191 po angielsku.
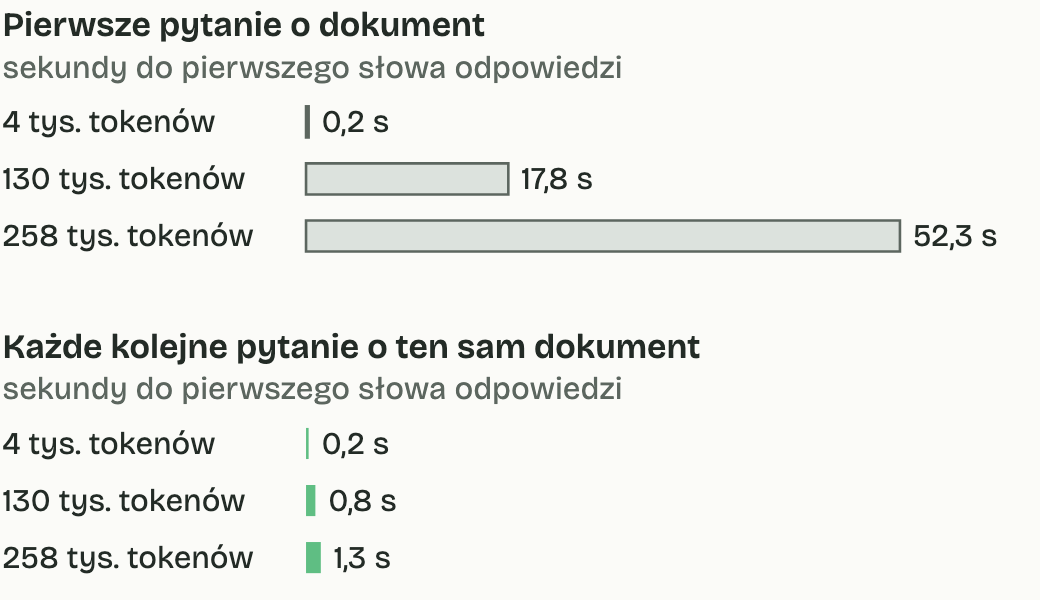
Nasz kalkulator LLM na GPU szacuje to czekanie dla innych kart i modeli. Dla Qwen3.8-27B na H200 z promptem o długości 254 tys. tokenów podaje 45-46 sekund, a zmierzyliśmy 51, więc przy bardzo długich promptach jego wynik jest niższy od zmierzonego. Te czasy zmierzyliśmy, gdy karta była w większości wolna; inne zapytania działające obok długiego promptu je wydłużają, co pokazuje sekcja o własnym serwerze. Na pierwszą odpowiedź czeka się długo tylko raz na dokument, o ile kolejne pytania mogą skorzystać z już przeczytanego tekstu.
Kolejne pytania korzystają z tego, co serwer już przeczytał
Serwer prowadzi pamięć podręczną promptów, czyli zachowuje wewnętrzny stan promptu, który już przeczytał, a kolejne zapytanie zaczynające się tym samym tekstem pomija czytanie tej części. Odpowiedzi na kolejne pytania o ten sam dokument przychodziły po 0,6-1,0 sekundy przy około 130 tys. tokenów i po 1,1-1,6 sekundy przy około 260 tys. Żeby z tego skorzystać, część stałą, czyli instrukcje i dokument, trzeba umieścić na początku, a pytanie na końcu, i za każdym razem wysyłać dokument bez zmian: serwer wykorzystuje tylko początek identyczny z tym, który już przeczytał. W Blixild AI pamięć podręczna każdego klienta jest oddzielna, więc zapytania klienta przyspieszają tylko jego własne wcześniejsze zapytania.
Przy niektórych dokumentach drugie pytanie trwa tyle samo co pierwsze: w naszych pomiarach przy jednym z sześciu długich dokumentów, 17 sekund przy 131 tys. tokenów. Serwer zaznacza zakładką, dokąd doczytał, a przy tym modelu zakładka może stać tylko na wielokrotności 1600 tokenów, więc wypada do 1600 tokenów przed końcem zapytania. Przy pięciu pozostałych dokumentach zakładka wypadła w dokumencie i kolejne pytanie zaczynało od niego. Gdy wypadnie w pierwszym pytaniu, zakładka obejmuje słowa, których drugie pytanie nie zawiera, więc serwer czyta cały dokument od nowa. Następne pytania znów były szybkie. Krótkie pytanie po dokumencie sprawia, że zdarza się to rzadziej.
Pamięć podręczna oszczędza czas, a nie pieniądze. Każde pytanie jest rozliczane za cały dokument, więc przy cenie 0,20 USD za milion tokenów wejścia pytanie o dokument z 260 tys. tokenów kosztuje około 0,05 USD, a dziesięć pytań około 0,52 USD. Przy jednorazowych pytaniach do wielu dokumentów taniej i szybciej wyjdzie wyszukiwanie, które wysyła modelowi tylko pasujące fragmenty. Jak długo serwer przechowuje dokument między pytaniami, zależy od obciążenia karty; tego nie mierzyliśmy.
Qwen3.8-27B na własnej karcie H200
Te same pomiary przydadzą się zespołom, które uruchamiają model u siebie. U nas model działa w vLLM, otwartym programie, który udostępnia modele przez API zgodne z OpenAI, na jednej karcie H200 NVL ze 141 GB pamięci, w wersji FP8 i z pamięcią podręczną zapisaną w 8 bitach:
- model zajmuje około 28 GiB, a 72 GiB przeznaczone na pamięć podręczną mieszczą około 2 mln tokenów, czyli od siedmiu do ośmiu zapytań pełnej długości naraz;
- odpowiedzi na osiem zapytań naraz model pisze z łączną szybkością około 1100 tokenów na sekundę, przy krótkich promptach;
- długi prompt jest czytany porcjami, a każda porcja wstrzymuje inne zapytania na karcie.
Ustawienie vLLM --long-prefill-token-threshold ogranicza, ile długiego promptu jest czytane w jednym kroku, gdy działają inne zapytania. Przy 1024 tokenach na krok pozostałe zapytania zachowały 9-14 tokenów na sekundę obok promptu z 254 tys. tokenów, którego pierwszy token pojawił się po 63 sekundach zamiast po 51. Niższa wartość jeszcze bardziej sprzyjałaby pozostałym zapytaniom kosztem długiego promptu; tego nie mierzyliśmy. Te liczby dotyczą tej karty i tej wersji modelu; dla innej karty pierwszy szacunek da kalkulator wspomniany wyżej. O tym, jak udostępnić taki serwer z kluczami i cenami, piszemy w poradniku o API LLM na własnym sprzęcie.
Od czego zacząć przy długich dokumentach
Zespół, który zadaje kilka pytań o jeden zestaw dokumentów, może wysłać cały zestaw w jednym zapytaniu i spodziewać się pierwszej odpowiedzi po około minucie przy pełnej długości, a kolejnych po około sekundzie. Zespołowi z jednorazowymi pytaniami do wielu dokumentów lepiej posłuży wyszukiwanie, które najpierw wybiera fragmenty. Zespół, który uruchamia model u siebie, powinien ustawić limit dla długich promptów, zanim trafią do niego długie dokumenty, żeby jeden z nich nie wstrzymywał wszystkich pozostałych. Pierwsze kroki:
- Zalogować się w serwisie Blixild AI, gdzie od razu dostępne są klucz API i 1 USD środków na start.
- Wysłać jeden z własnych dokumentów i pytanie do modelu
qwen3.8-27bz wyłączonym rozumowaniem, jak w przykładzie wyżej. - Kolejne pytania zadawać z niezmienionym dokumentem w tym samym miejscu, a tekst po nim zostawić krótki.
- Zmierzyć czas pierwszej i kolejnych odpowiedzi na własnych dokumentach i porównać koszt pytania z wyszukiwaniem, które wysyła tylko fragmenty.
Qwen3.8 27B działa w Blixild AI na naszej karcie H200 w Polsce, w cenie 0,20 USD za milion tokenów wejścia i 1,50 USD za milion tokenów wyjścia. Model, który ma działać w siedzibie klienta lub na jego koncie w chmurze, uruchamiamy i utrzymujemy w ramach naszego hostingu AI.
Pojęcia
- Czas do pierwszego tokena
- Czas od wysłania zapytania do pierwszego słowa odpowiedzi. Model czyta w tym czasie cały prompt.
- Pamięć podręczna promptów
- To, co serwer zachowuje z przeczytanego promptu, żeby kolejne zapytanie zaczynające się tym samym tekstem nie musiało go czytać od nowa.
- Token
- Token to fragment słowa. Modele czytają i piszą tokeny, a cenniki API liczą opłaty od tokenów.
Źródła
- Qwen (2026). Qwen3.8-27B-FP8, karta modelu. https://huggingface.co/Qwen/Qwen3.8-27B-FP8
- vLLM (2026). Automatic prefix caching. https://docs.vllm.ai/en/stable/features/automatic_prefix_caching.html
- vLLM (2026). Engine arguments. https://docs.vllm.ai/en/stable/configuration/engine_args.html
- Prus, B. (1890). Lalka. Wolne Lektury. https://wolnelektury.pl/katalog/lektura/lalka/
- Austen, J. (1813). Pride and Prejudice. Project Gutenberg eBook #1342. https://www.gutenberg.org/ebooks/1342