Model na własnej karcie graficznej może odpowiadać zespołowi albo płacącym klientom przez API, z osobnym kluczem dla każdego z nich, ceną za token i blokadą, gdy skończą się środki, a sama karta nigdy nie dostaje adresu w internecie. Umożliwia to kilka narzędzi o otwartym kodzie i operator płatności, a przy każdym z nich łatwo o błąd w ustawieniach.
Ten wpis omawia je w kolejności, w jakiej warto je budować, na przykładzie Blixild AI, naszego API LLM na własnym sprzęcie. Usługa udostępnia otwarte modele z kart RTX 3090 i RTX 5090 w naszych serwerach w Polsce. Przy każdym etapie drogi zapytania wyjaśniam, co robi dane narzędzie, dlaczego je wybrałem i na co uważać.
Po drodze wpis pokazuje, że karta miała o jedną czwartą mniej pamięci na rozmowy, niż szacował nasz kalkulator, i dlaczego serwera modelu nie chroni jego własne sprawdzanie kluczy. Wyjaśnia, dlaczego długi prompt może utknąć tam, gdzie krótkie zapytania przechodzą, i dlaczego każda płatność dociera dwa razy. Kończy się tym, czego nie potrzebuje jedna osoba ani firma, która udostępnia model własnym pracownikom, oraz sześcioma krokami budowy.
Napisałem go dla inżynierów, którzy chcą udostępnić otwarty model przez API, na potrzeby własnej firmy albo dla klientów. Dlaczego udostępniamy w ten sposób Arete 27B, wyjaśnia wcześniejszy wpis.
Czego API modelu potrzebuje poza samym modelem
Oprogramowanie serwera modelu ładuje model do pamięci karty graficznej (GPU) i odpowiada na zapytania. Usługa potrzebuje czegoś więcej. Trzeba wiedzieć, kto pyta, liczyć tokeny, wyceniać je i wstrzymać zapytania, gdy skończą się środki. Klienci potrzebują sposobu, żeby się zalogować i zapłacić, a ja muszę wiedzieć, że to wszystko działa.
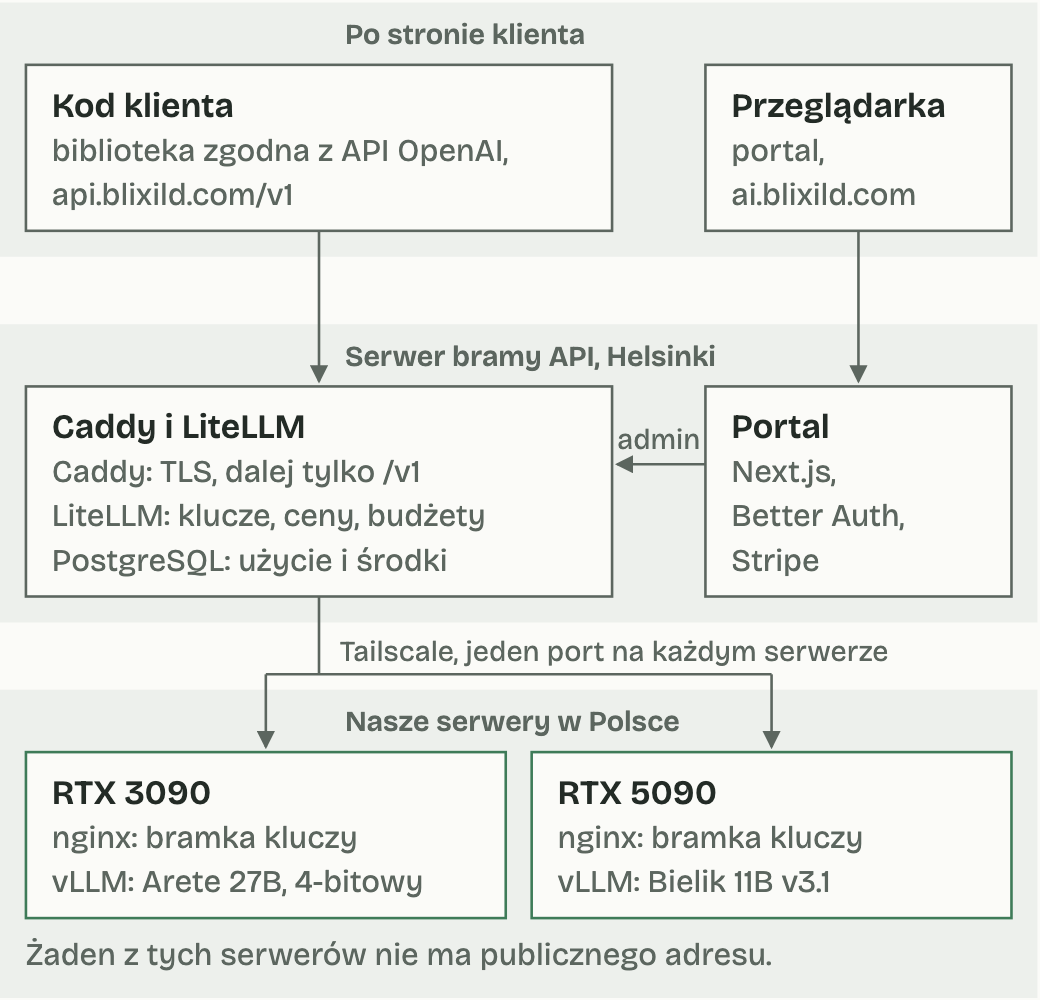
Trzymałem się jednej zasady: do każdego zadania gotowe narzędzie, a własny kod tylko tam, gdzie narzędzia się łączą. Rysunek pokazuje, jak to wygląda na drodze jednego zapytania. Jedyną maszyną dostępną z internetu jest mały serwer w Helsinkach, a karty stoją za nim. Kolejne sekcje omawiają etapy w kolejności, w jakiej je budowałem, zaczynając od kart: kartę i jej serwer modelu, bramkę kluczy przed nim, bramę API, która nalicza opłaty za tokeny, portal, w którym logują się klienci, i testy, które sprawdzają całość.
Kalkulator dobiera kartę, a działające API sprawdza szacunek
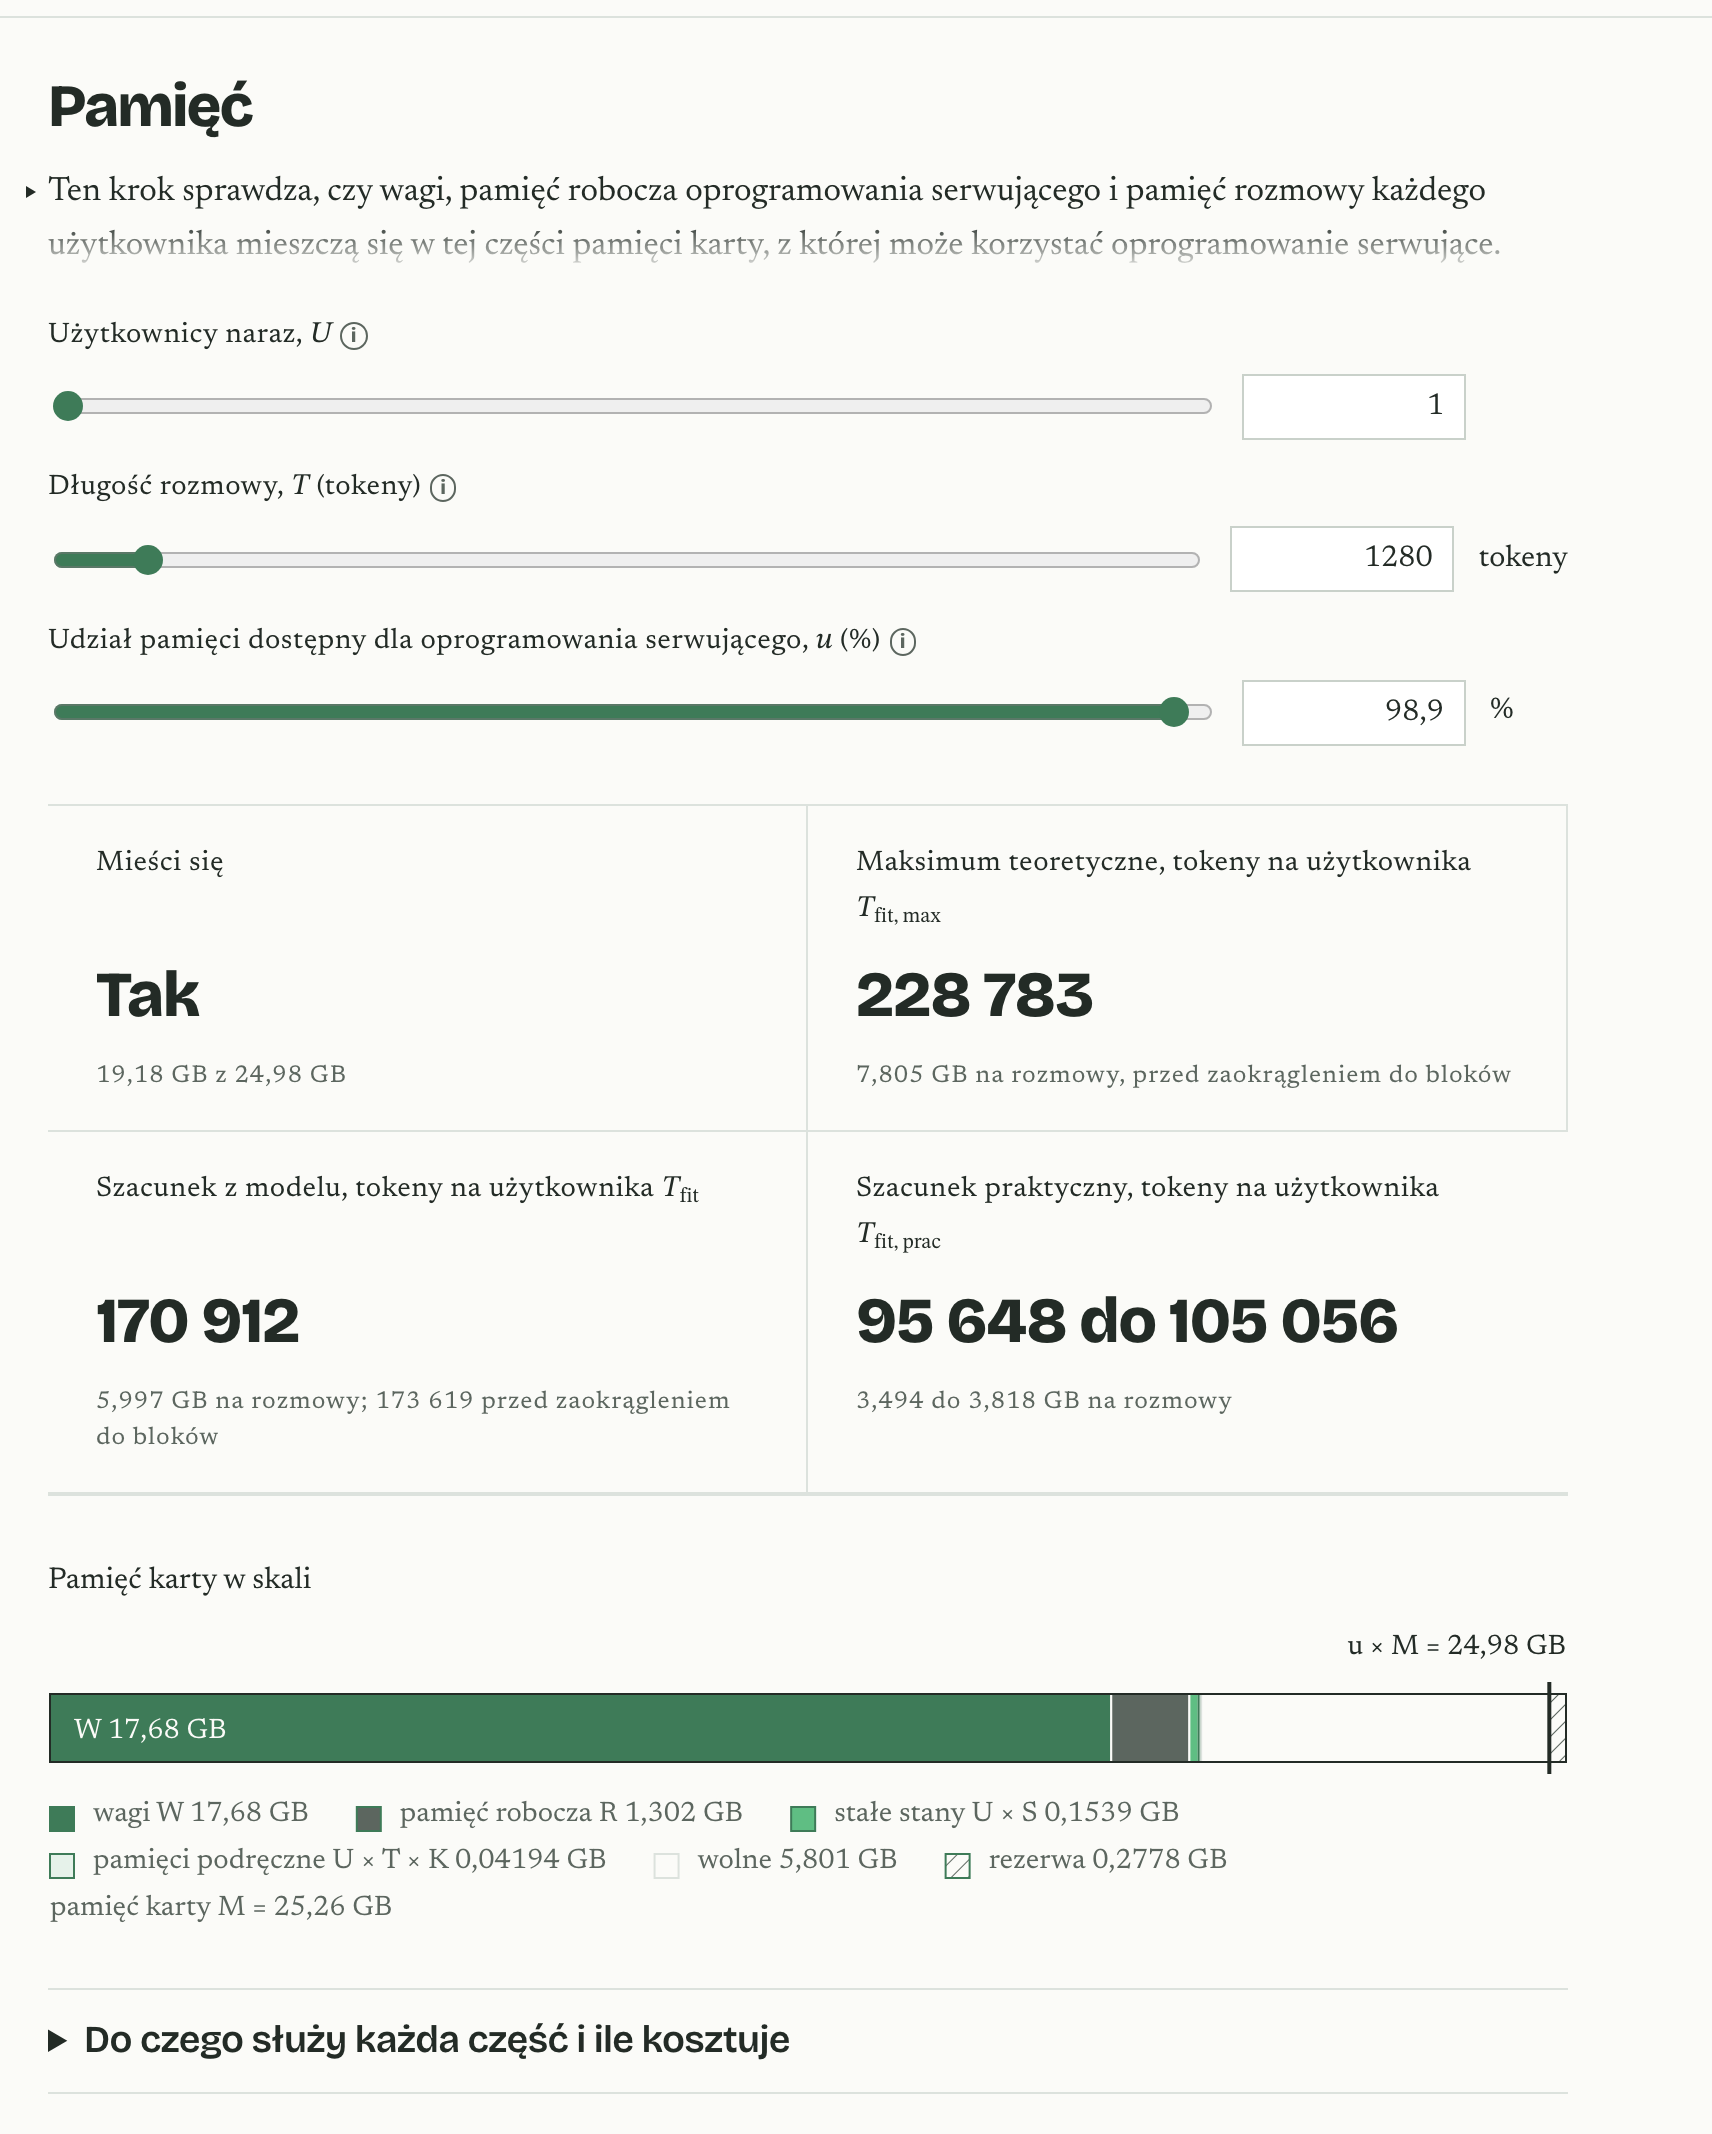
Pierwszym etapem jest karta, a pierwsze pytanie brzmi, czy model się na niej zmieści i jak szybko będzie odpowiadał. Nasz Kalkulator LLM na GPU szacuje jedno i drugie, zanim cokolwiek zostanie załadowane. Przyjmuje kartę, model, rozmiar jego wag i liczbę jednoczesnych zapytań. Zwraca pamięć pozostałą na rozmowy, czas do pierwszego tokenu i liczbę tokenów na sekundę dla każdego użytkownika.
Na potrzeby tego wpisu wprowadziłem do kalkulatora konfigurację karty RTX 3090 z Arete 27B i zapisałem wyniki, zanim porównałem je z pomiarami. Tabela pokazuje jedno i drugie.
| Kalkulator, szacunek praktyczny | Działające API, pomiar | |
|---|---|---|
| Pamięć na rozmowy | od 147 000 do 174 000 tokenów | 109 000 tokenów |
| Szybkość jednego zapytania | od 43,0 do 47,1 tok./s | 46,9 tok./s |
| Szybkość każdego z dwóch długich zapytań naraz | od 39,3 do 43,6 tok./s | 40,8 tok./s |
| Pierwszy token po prompcie z 1000 tokenów | od 0,71 do 0,77 s | 0,79 s |
Szybkości zmieściły się w zakresie kalkulatora, a pierwszy token pojawił się o 2% później niż górna granica zakresu. Pamięć na rozmowy się nie zgadzała: działające API miało jej o około jedną czwartą mniej niż najniższy szacunek. Źródło różnicy widać w dzienniku, który serwer modelu zapisuje przy starcie. Serwer zarezerwował około trzech razy więcej pamięci roboczej, niż kalkulator zakładał dla modelu obsługującego tylko tekst.
Szacunek praktyczny kalkulatora uwzględnia teraz tę większą pamięć roboczą. Dla tej samej konfiguracji daje od około 96 000 do 105 000 tokenów, czyli nieco mniej niż 109 000 zmierzonych w działającym API.
Szacunek pozwala wybrać kartę, ale nie wyznacza granic usługi. Wyznacza je dopiero test, w którym karta obsługuje maksymalną liczbę jednoczesnych zapytań i najdłuższe prompty, jakie model przyjmuje, bo taki test pokazuje, ile pamięci zostaje w najgorszym momencie. Ani szacunek, ani te pomiary nie mówią, jak dobrze model odpowiada.
vLLM uruchamia jeden model na każdej karcie
Gdy karta jest już wybrana, kolejnym wyborem jest oprogramowanie, które ładuje na nią model i odpowiada na zapytania. Używam vLLM, bo obsługuje kilka zapytań naraz na jednej karcie i posługuje się tym samym formatem co API OpenAI. Jeden proces vLLM obsługuje jeden model, więc na jednej karcie działa jeden model: Arete 27B na karcie RTX 3090, a Bielik 11B v3.1 na karcie RTX 5090.
Każdy model musi zmieścić się na swojej karcie. Bielik mieści się w 32 GB karty 5090, gdy każda jego waga zajmuje 8 bitów. Arete 27B w pełnej precyzji potrzebuje ponad dwa razy więcej niż 24 GB karty 3090, więc na tej karcie działa jego wersja 4-bitowa. Taka wersja może mieć niższą dokładność, a w przypadku Arete jeszcze nie zmierzyłem, o ile.
Pamięć, którą zostawiają wagi, mieści rozmowy w toku. Na karcie 3090 zapisanie tej pamięci na rozmowy w 8 bitach i pominięcie wejścia obrazowego modelu mniej więcej podwoiły to miejsce. vLLM potrafi też w każdym kroku proponować kilka tokenów naprzód, co na tej karcie dawało około półtora raza szybszą odpowiedź na pojedyncze zapytanie, ale kosztowało 60% tego miejsca. Wybrałem więcej pamięci na rozmowy, bo potrzebują jej długie dokumenty i agenci.
Dwa ustawienia wymagają uwagi:
- Pamięć na rozmowy trzeba ustawić samemu. Domyślnie vLLM przy każdym starcie mierzy swoją pamięć roboczą i resztę oddaje na rozmowy. Ten pomiar może się różnić między startami, a start, który odda rozmowom za dużo, kończy się brakiem pamięci. Ze stałym rozmiarem, przyjętym z testu, który wytrzymał maksymalną liczbę jednoczesnych zapytań, vLLM za każdym razem startuje tak samo.
- Wywoływanie narzędzi trzeba włączyć i przetestować. Działa tylko wtedy, gdy vLLM startuje z parserem dla formatu danego modelu, a oba nasze modele potrzebują różnych parserów. Bez parsera zwykła rozmowa działa, a każde zapytanie z listą narzędzi kończy się błędem.
Z tymi ustawieniami model odpowiada każdemu, kto dotrze do jego portu. Następny etap decyduje, kto może tam dotrzeć.
Karty są niedostępne z internetu
vLLM potrafi sam sprawdzać klucz API, ale ta opcja chroni tylko część jego adresów. Inne adresy na tym samym porcie odpowiadają bez klucza, a wśród nich jest taki, który generuje tekst. Dokumentacja vLLM sama zaleca, żeby nie polegać wyłącznie na tej opcji i postawić przed serwerem reverse proxy.
Postawiłem tam nginx jako bramkę kluczy, taką samą na każdym serwerze GPU. Bramka przepuszcza zapytania pod /v1 ze znanym kluczem, a wszystkie inne odrzuca. vLLM nasłuchuje tylko na samej maszynie, więc bramka jest jedyną drogą do niego.
Do bramki kluczy musi docierać tylko jedna maszyna: serwer bramy API w Helsinkach. Łączy się przez Tailscale, prywatną, szyfrowaną sieć między naszymi maszynami. Zasady dostępu w tej sieci pozwalają bramie API dotrzeć do tego jednego portu na każdym serwerze GPU i do niczego więcej, a zasady mają własne testy, które nie przechodzą, jeśli zmiana otworzy coś więcej. Zanim usługa zacznie zależeć od tej sieci, warto sprawdzić plan: darmowy plan Tailscale jest przeznaczony do użytku niekomercyjnego.
Bramka decyduje tylko o tym, kto wchodzi. Nie prowadzi budżetów i nie liczy tokenów, a to jest zadanie bramy API.
LiteLLM zamienia tokeny na opłaty
Bramą API jest LiteLLM, oprogramowanie o otwartym kodzie, które pośredniczy w zapytaniach do API modeli. Każdy model to jeden wpis w konfiguracji LiteLLM, z adresem i kluczem serwera, na którym model działa, więc zapytanie wskazujące Bielika trafia do karty 5090, a zapytanie wskazujące Arete do karty 3090.
LiteLLM wydaje klucze, których używają klienci, liczy tokeny każdego zapytania i odlicza ich koszt od budżetu klienta. Gdy budżet się wyczerpie, odrzuca zapytania, a do tego ogranicza liczbę zapytań, które jeden klucz może wysyłać naraz. Przed nim stoi serwer WWW Caddy, który uzyskuje certyfikaty TLS i przekazuje dalej tylko adresy /v1. Oba działają w kontenerach na serwerze bramy API, obok bazy danych PostgreSQL. Brama API i portal mają ten serwer tylko dla siebie.
Trzy rzeczy wymagają tu uwagi:
- Każdy własny model trzeba wycenić, zanim klienci dostaną środki. LiteLLM zna ceny publicznych modeli. Własny model nie ma ceny, dopóki obie jego stawki nie znajdą się w konfiguracji, a zapytanie bez ceny nie pobiera nic ze środków. Mój test wysyła prawdziwe zapytanie do każdego modelu i porównuje opłatę z jego opublikowaną ceną.
- Publicznie dostępne powinno być tylko /v1. API administracyjne LiteLLM zarządza kluczami i budżetami, więc zostaje po stronie prywatnej, gdzie wywołuje je tylko portal.
- Najdłuższy prompt trzeba przetestować na każdym odcinku drogi. Długi prompt oznacza przesłanie dużej porcji danych, a ta może utknąć w warstwie, której krótkie zapytania nigdy nie obciążają. W Dockerze bez uprawnień administratora (rootless Docker) tą warstwą był program pasta, który obsługuje sieć kontenera w przestrzeni użytkownika. Znalazł go pomiar czasu na każdym odcinku osobno, a problem usunęła zmiana sterownika sieci na slirp4netns.
LiteLLM nie ładuje ani nie wymienia modeli, nie obsługuje też logowania i nie przyjmuje płatności. Każdego klienta trzeba założyć, a jego budżet podnieść, gdy zapłaci, i tym zajmuje się portal.
Portal obsługuje logowanie, środki i płatności
Portal pod adresem ai.blixild.com to część, którą napisałem sam: aplikacja Next.js z biblioteką Better Auth do logowania. Klienci logują się wyłącznie kontem Google lub GitHub, więc portal nie przechowuje haseł, a każdy adres e-mail przychodzi już zweryfikowany. Przy pierwszej wizycie portal zakłada klienta w LiteLLM z kluczem i 1 USD środków na start.
Środki klienta są zapisane w bazie danych portalu jako rejestr wpisów: środki na start i doładowania. Każdy wpis ustawia budżet klienta w LiteLLM na sumę z rejestru. Klienci doładowują środki, płacąc przez Stripe, który działa jako merchant of record: sprzedaje środki we własnym imieniu, wylicza i odprowadza VAT albo podatek od sprzedaży należny w kraju kupującego i wysyła mu potwierdzenie zakupu.
Tu również trzy rzeczy wymagają uwagi:
- Każda płatność dociera dwa razy. Portal dowiaduje się o niej, gdy klient wraca ze strony płatności, i ponownie z webhooka, który Stripe wysyła ponownie, gdy nie dostanie odpowiedzi. Dlatego każdy wpis zawiera identyfikator płatności i liczy się tylko raz.
- Trzeba określić, czy podatek jest wliczony w cenę. Jeśli wywołanie API tego nie określa, o tym, czy podatek jest wliczony w cenę, czy doliczany do niej, decyduje ustawienie domyślne konta Stripe, a konto testowe i konto produkcyjne mogą się tu różnić.
- Zależności trzeba sprawdzić przed uruchomieniem. Projekt, który zaczyna się od szablonu albo przykładu, dziedziczy wersje bibliotek z dnia, w którym powstał szablon lub przykład, a część z nich ma już znane luki bezpieczeństwa.
Portal sprzedaje tylko środki opłacane z góry. Nie ma subskrypcji i nie wystawia własnych faktur.
Jeden test sprawdza całą drogę
Na tym droga jest kompletna, od logowania w portalu do karty. Każde narzędzie na niej przechodzi własne testy, a usługa i tak może zawieść na styku między nimi. Dlatego jeden test obejmuje całą drogę, z prawdziwymi modelami i przez publiczny adres. Zakłada tymczasowego klienta i wysyła płatne zapytanie. Sprawdza, czy opłata zgadza się z opublikowaną ceną, czy zapytania zatrzymują się przy 0 USD i czy usunięty klucz przestaje działać. Na koniec potwierdza, że dzienniki nie przechowują promptu. Obietnica prywatności zależy od ustawień, a ten test sprawdza je po każdej zmianie.
Podczas pracy usługi brama API stale wysyła do każdego modelu krótkie prawdziwe zapytanie, tą samą drogą, którą idą zapytania klientów. Gdy model przestaje odpowiadać, serwer bramy API wysyła e-mail, więc alert nie zależy od maszyny, której dotyczy.
Jeden szczegół wymaga celowego testu. Reguła ponownego uruchamiania, która czeka na kod błędu, nie zauważy serwera modelu, który zamyka się poprawnie po awarii swojego silnika. Odkryłem to, celowo zatrzymując silnik, i teraz kontenery uruchamiają się ponownie zawsze, gdy się zatrzymają.
Żaden z tych testów nie mierzy jakości odpowiedzi. Do tego potrzebne są testy samego modelu na zadaniach, do których będzie używany.
Mniejszy system potrzebuje mniej etapów
Blixild AI sprzedaje dostęp osobom, których nigdy nie spotkałem, więc potrzebuje wszystkich opisanych etapów. System, z którego korzysta mniej obcych osób, potrzebuje mniej etapów, a ta sama kolejność pokazuje, których.
- Jedna osoba, jedna maszyna. Karta, jej dobór i vLLM to cały system, dopóki model jest używany na maszynie, na której działa. Gdy ma do niego docierać laptop albo telefon, wystarczy dodać bramkę kluczy i prywatną sieć. Tak działało Blixild AI, zanim pojawili się klienci.
- Firma, która udostępnia model własnym pracownikom i aplikacjom. Bramkę kluczy i prywatną sieć warto zachować, a dodać bramę API. Jej klucze przypisuje się wtedy zespołom albo aplikacjom zamiast klientom. Budżety i limit jednoczesnych zapytań nie pozwalają jednemu skryptowi zająć całej karty, a zapisy użycia pokazują, kto ile potrzebuje, i na nich opiera się decyzja o drugiej karcie. Portal i płatności można pominąć, bo pracownicy mają już konta i nikt nie płaci kartą płatniczą.
Sześć kroków od karty do usługi
Droga opisana w tym wpisie wyznacza też kolejność budowy. Zaczyna się od karty, a każdy krok sprawdza się przed następnym. To, jak daleko nią pójść, zależy od tego, kto będzie korzystał z modelu. Jednej osobie wystarczą kroki od 1 do 3, firmie, która udostępnia model własnym pracownikom, kroki od 1 do 4, a publiczna usługa potrzebuje wszystkich. Krok 6 dotyczy każdej skali.
- Dobrać kartę. Najpierw oszacować, czy model się zmieści i jak szybko będzie odpowiadał, a potem zmierzyć go przy maksymalnej liczbie jednoczesnych zapytań.
- Uruchomić model. Na każdej karcie uruchomić jeden model, ustawić mu pamięć na rozmowy i przetestować wywoływanie narzędzi.
- Chronić serwer modelu. Postawić przed nim bramkę kluczy i łączyć się z nim przez prywatną sieć.
- Rozliczać użycie. Dodać bramę API, która wydaje klucze, wycenia tokeny i pilnuje budżetów, i ustalić, co mogą przechowywać jej dzienniki. Sprawdzić ją na jednym testowym kliencie, aż do odmowy przy 0 USD.
- Udostępnić usługę. Nadać jej publiczny adres, który przekazuje dalej tylko API, a potem dodać logowanie, środki i płatności.
- Sprawdzać całą drogę. Po każdej zmianie uruchamiać jeden test od początku do końca i stale wysyłać do każdego modelu prawdziwe zapytanie.
Przy każdej kolejnej karcie powtarza się kroki od 1 do 3 i dodaje jeden wpis do konfiguracji bramy API.
Żeby zobaczyć efekt od strony klienta, wystarczy zalogować się w serwisie ai.blixild.com kontem Google lub GitHub. Klucz API i 1 USD środków na start są dostępne od razu, bez podawania karty płatniczej, a z adresem api.blixild.com/v1 współpracuje każda biblioteka zgodna z API OpenAI.
Taki system w siedzibie klienta lub na jego koncie w chmurze, z modelem wybranym przez klienta, uruchamiamy i utrzymujemy w ramach naszego hostingu AI.
Pojęcia
- LLM
- LLM to duży model językowy, wytrenowany na dużych zbiorach tekstu. Większość pisze odpowiedź token po tokenie.
- Merchant of record
- Merchant of record to firma, która sprzedaje kupującemu we własnym imieniu i bierze na siebie podatek oraz potwierdzenia zakupu.
- Reverse proxy
- Reverse proxy to serwer, który przyjmuje zapytania w imieniu innego serwera i przepuszcza tylko to, na co pozwalają mu reguły.
- TLS
- TLS to szyfrowanie, na którym działa https.
- Token
- Token to fragment słowa. Modele czytają i piszą tokeny, a cenniki API liczą opłaty od tokenów.
- Webhook
- Webhook to wiadomość, którą jedna usługa wysyła na adres innej, gdy coś się wydarzy, na przykład gdy płatność zostanie zrealizowana.
- Wersja 4-bitowa
- Wersja 4-bitowa to kopia modelu, w której każda waga zajmuje 4 bity zamiast 16, więc model potrzebuje około czterech razy mniej pamięci.
- Wywoływanie narzędzi
- Model prosi program, który go wywołuje, o uruchomienie funkcji, a potem pracuje dalej na jej wyniku. Tak działają agenci.
Źródła
- vLLM (2026). Security, odczyt 19 listopada 2026 r. https://docs.vllm.ai/en/latest/usage/security.html
- LiteLLM (2026). Custom LLM Pricing. https://docs.litellm.ai/docs/proxy/custom_pricing
- LiteLLM (2026). Spend Tracking. https://docs.litellm.ai/docs/proxy/cost_tracking
- Tailscale (2026). Tailscale pricing, odczyt 19 listopada 2026 r. https://tailscale.com/pricing
- Stripe (2026). How Managed Payments works. https://docs.stripe.com/payments/managed-payments/how-it-works