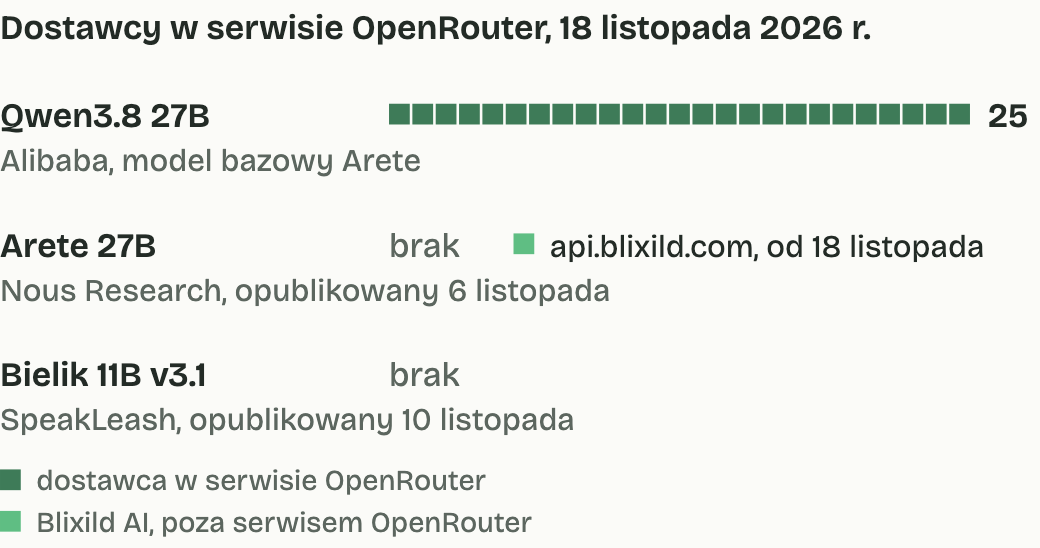
Zespół Nous Research opublikował 6 listopada 2026 r. model Arete 27B, a w ciągu kilku dni powstały dziesiątki jego kopii do uruchomienia na własnych kartach graficznych. Nikt jednak nie oferował najprostszego sposobu, żeby go wypróbować: API, czyli płatnego za użycie adresu w internecie, na który program wysyła tekst i z którego otrzymuje odpowiedź. Szukaliśmy i nie znaleźliśmy żadnego. W tej samej sytuacji był Bielik 11B v3.1, polski model opublikowany cztery dni później.
Od 18 listopada Arete 27B odpowiada w usłudze Blixild AI, pod adresem api.blixild.com, i działa na jednej karcie RTX 3090 w naszym serwerze poprzedniej generacji w Polsce. W trakcie tej pracy zrozumieliśmy, dlaczego model tak łatwy do pobrania jest tak trudno dostępny przez API i co może zmienić jedna karta graficzna. Opisujemy tę drogę z myślą o programistach, którzy chcą wypróbować otwarte modele, i o inżynierach, którzy uruchamiają je na własnych kartach.
Model, który wszyscy pobierają, a którego nikt nie udostępnia przez API
Arete to model dostrojony: zespół Nous dotrenował Qwen3.8 27B, mocny otwarty model firmy Alibaba, tak żeby model odpowiadał na pytania o wartości z perspektywy tego, co Nous nazywa „wartościami zachodnimi”. W teście zespołu Nous, złożonym z 803 pytań o wolność słowa, prywatność, demokrację i podobne tematy, Arete podaje więcej sprawdzonych faktów niż model, z którego powstał. W teście ogólnych umiejętności wypada tak samo jak model bazowy.
Ma to znaczenie nie tylko dla tego jednego modelu. Skoro niewielkie dotrenowanie zmienia wartości modelu, te wartości można sprawdzać, porównywać i wybierać, a zespół Nous publikuje wagi, dane i test, żeby każdy mógł to zrobić. Dla osób, które używają modelu do badań, pisania lub nauczania, jest to wybór, którego wcześniej nie miały.
Na pobraniu ten wybór się jednak kończy. Popularny Qwen3.8 27B jest dostępny przez API u 25 dostawców w serwisie OpenRouter, który łączy ofertę wielu dostawców w jednym API. Arete nie miał tam żadnego dostawcy, gdy sprawdziliśmy to 18 listopada.
Godzina pracy GPU decyduje, z których modeli można korzystać
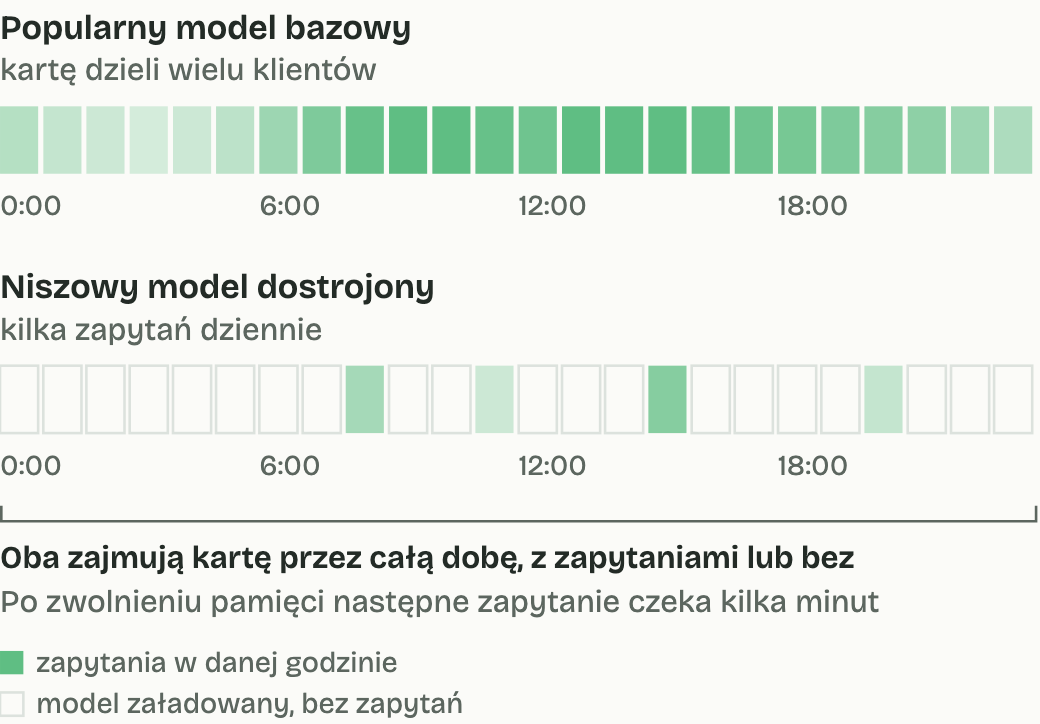
Przyczyną nie jest model, tylko sprzęt, który stoi za każdym API. Model odpowiada tylko wtedy, gdy jest załadowany do pamięci karty graficznej, czyli GPU, i zajmuje tę pamięć bez względu na to, czy ktoś wysyła zapytania. Dla dostawcy każda godzina, w której model jest załadowany, to opłacona godzina pracy GPU.
Popularny model wypełnia te godziny zapytaniami wielu klientów. Model dostrojony, taki jak Arete, albo model regionalny, taki jak Bielik, ma zbyt mało użytkowników, żeby je wypełnić. Dostawca może trzymać go w pamięci i płacić za bezczynne godziny albo zwolnić pamięć, a wtedy następna osoba czeka kilka minut, aż model znów się załaduje. Żadna z tych możliwości się nie opłaca, więc dostawcy udostępniają modele, których wszyscy już używają, a nowe muszą czekać na swoją kolej.
Co oznacza uruchomienie Arete 27B u siebie
Alternatywą jest uruchomienie modelu u siebie: na karcie do gier, na karcie do stacji roboczych, na komputerze Mac z dużą pamięcią albo na GPU wynajmowanym na godziny. My wybraliśmy RTX 3090, która zwolniła się na początku listopada, gdy w innej maszynie wymieniliśmy kartę na nowszą. NVIDIA wprowadziła ją na rynek w 2020 r. w cenie 1499 USD jako swoją najmocniejszą kartę do gier, a jej 24 GB pamięci wystarczają do uruchomienia modelu wielkości Arete. Dlatego RTX 3090 często wybierają osoby, które uruchamiają modele w domu.
Jej cena pokazuje, jak bardzo jest poszukiwana. Jesienią 2025 r. używana karta 3090 kosztowała od 600 do 900 USD. W kwietniu 2026 r. karty z trzech najtańszych ofert w serwisie eBay kosztowały średnio około 1090 USD, a w listopadzie używane karty 3090 były wystawiane w USA średnio za około 1660 USD, czyli drożej, niż kosztowała nowa karta sześć lat wcześniej. Podrożały też nowsze karty: w polskich sklepach RTX 5090 z wysyłką w ciągu jednego dnia kosztuje od 35 do 45 tys. zł z VAT, czyli od 8700 do 11 200 USD, przy cenie premierowej 1999 USD.
Sam sprzęt to jednak dopiero początek. Model trzeba zmniejszyć, żeby się zmieścił, a do wyboru są dziesiątki zmniejszonych wersji. Potem trzeba tak skonfigurować oprogramowanie, żeby model i prowadzone przez niego rozmowy mieściły się razem w pamięci.
Zmniejszenie modelu może obniżyć jego dokładność; w przypadku Arete jeszcze tego nie zmierzyliśmy.
Jedna karta RTX 3090 i publiczne API w ciągu tygodnia
Nasza karta 3090 ma teraz własny serwer i jedno zadanie. Model uruchomiony na karcie to jednak jeszcze nie usługa. Usługa wymaga kont i kluczy, ceny za tokeny (fragmenty słów, które model czyta i pisze) oraz adresu w internecie. Serwer z kartą nie ma publicznego adresu i go nie potrzebuje. Publiczna część, czyli brama API i portal, działa na osobnym serwerze w Helsinkach, który prowadzi konta klientów i ich środki, a z kartą komunikuje się przez szyfrowane połączenie, które otwiera jedne drzwi i nic więcej.
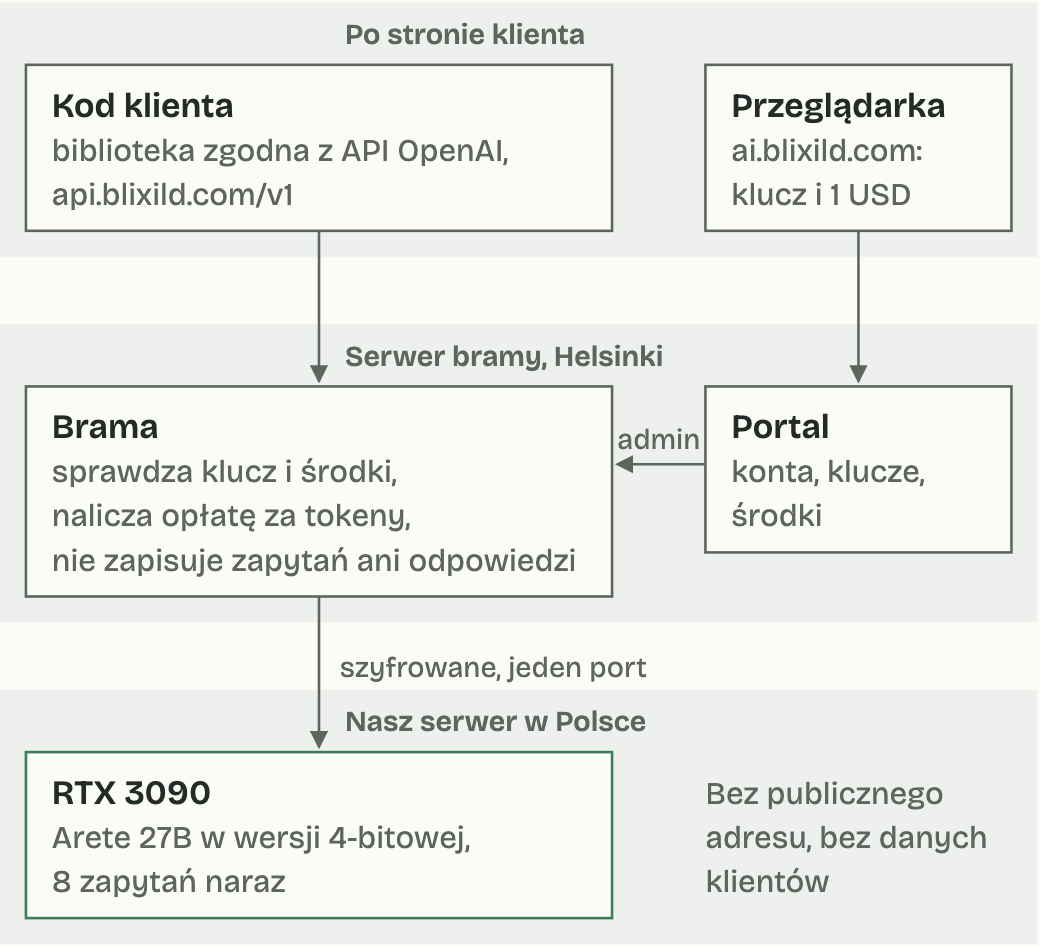
Dla klienta sprowadza się to do trzech rzeczy. Cena każdego modelu za milion tokenów jest podana na stronie głównej, a płaci się tylko za zużyte tokeny. Nie można wydać więcej, niż jest na koncie: gdy saldo spadnie do 0 USD, API przestaje przyjmować zapytania, a później nie przychodzi żaden rachunek. Wysyłane treści nie są przechowywane: nasze zapisy obejmują czas, liczbę tokenów i koszt, ale nigdy treści, a wszystko zostaje w UE.
Usługa przyjmuje tylko tekst, a jedna karta wystarcza, żeby wypróbować model na własnych zadaniach, zbudować i przetestować aplikację oraz korzystać z niego na co dzień na umiarkowaną skalę. Duże zadania wsadowe wymagają więcej niż jednej karty; do nich przygotowujemy sprzęt na wyłączność.
Niszowe modele dostępne jednym zapytaniem
Gdy model jest dostępny jednym zapytaniem, jego wypróbowanie kosztuje grosze. Wystarczy sprawdzić go na własnych dokumentach i trudnych przypadkach, żeby szybko ocenić, czy warto poświęcić mu więcej czasu, zanim kupi się kartę albo się ją wynajmie na godziny. Model, który dotąd tylko pobierano, zaczyna być używany, a jego twórcy zyskują nie tylko pobrania, ale i użytkowników.
W tym może pomóc mała firma z własnymi kartami. To API ma charakter pilotażowy: uruchomiliśmy je, żeby dać społeczności korzystającej z otwartych modeli to, czego jej brakuje, i rozbudujemy je o kolejne karty i modele, jeśli pojawi się zapotrzebowanie. Nasza karta jest już opłacona i pracuje w naszym serwerze, więc przy załadowanym modelu płacimy tylko za prąd, a nie za wynajem na godziny. Dzięki temu model z niewielką liczbą użytkowników może na nich poczekać. Zanim udostępnimy model, mierzymy jego działanie na naszych kartach. W październiku uruchamialiśmy Bielika na tej samej karcie 3090, a od 19 listopada Bielik 11B v3.1 także odpowiada w usłudze Blixild AI, na karcie RTX 5090.
Pierwsze zapytanie
Wystarczy zalogować się w serwisie ai.blixild.com kontem Google lub GitHub. Klucz API i 1 USD środków na start są dostępne od razu, bez podawania karty płatniczej, a panel pokazuje pierwsze zapytanie z już wpisanym kluczem. Z adresem api.blixild.com/v1 współpracuje każda biblioteka zgodna z API OpenAI.
curl https://api.blixild.com/v1/chat/completions \
  -H "Authorization: Bearer $BLIXILD_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "arete-27b", "messages": [{"role": "user", "content": "Hello!"}]}'
Arete w usłudze Blixild AI obsługuje też wywoływanie narzędzi (tool calling) w formacie OpenAI: model prosi program, który go wywołuje, o użycie narzędzia, na przykład wyszukiwania albo polecenia w terminalu, a potem pracuje dalej na jego wyniku. Tak działają agenci, wśród nich Hermes Agent, agent o otwartym kodzie od zespołu Nous Research, który ma w serwisie GitHub ponad 260 tys. gwiazdek. Zapamiętuje projekty użytkownika, w trakcie pracy tworzy umiejętności do ponownego użycia i wykonuje zadania według harmonogramu, z terminala albo z komunikatorów takich jak Telegram i Slack, na modelu wybranym przez użytkownika, a przy tym przyjmuje każdy adres zgodny z API OpenAI, taki jak ten.
Jakie inne otwarte modele chcieliby Państwo tu zobaczyć? Prosimy o wiadomość na adres kontakt@blixild.com z nazwą modelu i planowanym zastosowaniem. Te zgłoszenia decydują o tym, co dodamy w następnej kolejności.
Model, który ma działać w siedzibie klienta lub na jego koncie w chmurze, uruchamiamy i utrzymujemy w ramach naszego hostingu AI.
Źródła
- Nous Research (2026). Introducing Arete-27B: Qwen3.8-27B Post-Trained To Reinforce Western Values. https://nousresearch.com/arete
- Nous Research (2026). Arete-27B, karta modelu. https://huggingface.co/NousResearch/Arete-27B
- Bielik.ai (2026). Premiera modeli Bielik 11B v3.1, DFlash i rodziny Bielik-One. https://www.bielik.ai/blog/premiera-modeli-bielik-11b-v31-dflash-i-rodziny-bielik-one
- OpenRouter (2026). API modeli i lista dostawców Qwen3.8 27B, odczyt 18 listopada 2026 r. https://openrouter.ai/api/v1/models
- Hugging Face (2026). Inference Endpoints, cennik. https://huggingface.co/docs/inference-endpoints/pricing
- Replicate (2026). Run a model. https://replicate.com/docs/topics/models/run-a-model
- NVIDIA (2020). NVIDIA Delivers Greatest-Ever Generational Leap in Performance with GeForce RTX 30 Series GPUs. https://nvidianews.nvidia.com/news/nvidia-delivers-greatest-ever-generational-leap-in-performance-with-geforce-rtx-30-series-gpus
- Hardware Corner (2026). RTX 3090 Local LLM Benchmarks, Context Scaling and Supported Models. https://www.hardware-corner.net/gpu-llm-benchmarks/rtx-3090/
- ResalePrices (2026). RTX 3090 Used GPU Price and Fair Asking Range, odczyt 18 listopada 2026 r. https://resaleprices.com/gpu/nvidia-rtx-3090
- Ceneo (2026). RTX 5090, karty graficzne: oferty 28 modeli i czas wysyłki, odczyt 19 listopada 2026 r. https://www.ceneo.pl/Karty_graficzne;szukaj-rtx+5090
- GPU Poet (2026). NVIDIA GeForce RTX 3090 Price in April 2026. https://gpupoet.com/gpu/learn/price/april-2026/nvidia-geforce-rtx-3090
- GPU Poet (2026). October 2026 GPU Price/Performance Rankings. https://gpupoet.com/gpu/market-report/gpu-market-report-october-2026
- x-kom (2026). Wyniki wyszukiwania RTX 5090 z dostępnością i terminem dostawy, odczyt 19 listopada 2026 r. https://www.x-kom.pl/szukaj?q=rtx%205090
- Narodowy Bank Polski (2026). Kursy walut, tabela 224/A/NBP/2026 z 18 listopada 2026 r. https://api.nbp.pl/api/exchangerates/rates/a/usd/2026-11-18/
- Hacker News (2025). 25L Portable NV-linked Dual 3090 LLM Rig, dyskusja od 19 do 24 września 2025 r. https://news.ycombinator.com/item?id=45300668
- Nous Research (2026). Hermes Agent, repozytorium i README, odczyt 19 listopada 2026 r. https://github.com/NousResearch/hermes-agent
- bartowski (2026). NousResearch_Arete-27B-GGUF. https://huggingface.co/bartowski/NousResearch_Arete-27B-GGUF