W naszym teście Bielik 11B v3.1 w 2-3 sekundy sprawdził stany magazynowe, znalazł zamiennik brakującego towaru i złożył poprawne zamówienie, za każdym razem, po polsku i po angielsku. Wystarczyła mu procedura rozpisana krok po kroku w prompcie systemowym, czyli w instrukcji, którą program wysyła modelowi przed pytaniem. Z krótkim, ogólnym promptem zamiast procedury zabrakło mu wskazówki, co zrobić, gdy sklep odrzuci zamówienie, i jego odpowiedź rozminęła się z tym, co zwrócił sklep. Bielik dobrze sprawdza się więc jako agent, czyli program, który sam załatwia sprawę w kilku krokach, pod warunkiem że dostanie jasną procedurę.
Ten poradnik pokazuje, jak korzystać z Bielika przez API, czyli z własnego programu przez internet, i ilustruje każdą radę przykładem z naszych testów. Najważniejsze wnioski:
- wytyczne wbudowane w model dodają do każdego zapytania około tysiąca tokenów;
- rozumowanie jest domyślnie wyłączone i włącza się je jednym polem;
- agent potrzebuje procedury, w której każdy krok to jedno wywołanie narzędzia;
- obliczenia na datach lepiej zlecić narzędziu, a długie dokumenty model czyta pewnie.
Piszemy dla programistów, którzy budują czat, wyszukiwanie w dokumentach albo agenta działające po polsku, i dla tych, którzy uruchamiają Bielika u siebie. Kolejno: pierwsze zapytanie, rozumowanie, narzędzia, prompt agenta, obliczenia, długie dokumenty, własny serwer, zakres testów i pierwsze kroki. O Arete 27B, innym otwartym modelu, który udostępniamy przez API, piszemy w osobnym artykule.
Pierwsze zapytanie do Bielika przez API
Z Bielika 11B v3.1, którego fundacja SpeakLeash i ACK Cyfronet AGH opublikowały 10 listopada 2026 r. na licencji Apache 2.0, korzysta się przez API tak samo jak z modeli OpenAI. Wystarczą adres, klucz i nazwa modelu: w usłudze Blixild AI to https://api.blixild.com/v1, klucz z panelu po zalogowaniu i bielik-11b-v3.1.
curl https://api.blixild.com/v1/chat/completions \
  -H "Authorization: Bearer KLUCZ_API" \
  -H "Content-Type: application/json" \
  -d '{"model": "bielik-11b-v3.1",
       "messages": [{"role": "user",
         "content": "Czym jest Bielik? Odpowiedz w dwóch zdaniach."}]}'
To samo w Pythonie, z biblioteką openai:
from openai import OpenAI

client = OpenAI(base_url="https://api.blixild.com/v1", api_key="KLUCZ_API")
odp = client.chat.completions.create(
    model="bielik-11b-v3.1",
    messages=[{"role": "user",
               "content": "Czym jest Bielik? Odpowiedz w dwóch zdaniach."}],
)
print(odp.choices[0].message.content.strip())
Odpowiedź zaczyna się od pustego wiersza, stąd strip(). Pole usage podaje liczbę tokenów, czyli fragmentów słów, od których zależy cena, i już samo „Cześć!” liczy 1056 tokenów wejścia. To wytyczne modelu, które szablon rozmowy Bielika wstawia przed każdym zapytaniem: opis modelu, bieżąca data i zasady bezpieczeństwa. Własny prompt systemowy trafia pod nie. Wytyczne pomagają modelowi w zadaniach wieloetapowych, więc w naszej usłudze zostają. Liczą się jak każde wejście, co przy cenie 0,20 USD za milion tokenów daje około 0,0002 USD na zapytanie.
Zapytanie i odpowiedź razem mogą mieć do 32 768 tokenów, a model przyjmuje tylko tekst. Korzysta się z niego na warunkach fundacji SpeakLeash, które zabraniają między innymi przetwarzania danych osobowych. Na tak zadane pytanie Bielik odpowiada od razu, bez rozumowania, o które trzeba poprosić osobno.
Rozumowanie na żądanie
Przy trudniejszych zadaniach Bielik może przed odpowiedzią rozumować krok po kroku, według SpeakLeash także przy wywoływaniu narzędzi. Domyślnie tego nie robi, więc proste pytania dostają odpowiedź od razu i taniej. Rozumowanie włącza pole reasoning_effort z wartością low, medium, high albo max. Wraca ono w osobnym polu reasoning_content, a jego tokeny liczą się jako wyjście i wliczają do limitu max_tokens. Warto więc zostawić zapas, na przykład 2048 tokenów, bo zapytanie ucięte w trakcie rozumowania wraca bez odpowiedzi.
Zapytany „Ile to jest 17 × 23?” z reasoning_effort: low, model rozłożył mnożenie na 17 × 20 i 17 × 3 i odpowiedział „17 × 23 wynosi 391.”, zużywając w dwóch próbach 328 i 414 tokenów wyjścia. W 7 z 12 prób z pytaniami po polsku rozumował po angielsku, a odpowiadał zawsze po polsku i poprawnie. Poziom od low do high niewiele zmieniał długość rozumowania.
Rozumowanie przydaje się przy trudniejszych pytaniach, ale nie zastępuje procedury. Zestawienie zaległych faktur, które z procedurą Bielik wykonywał poprawnie, z krótkim promptem i włączonym rozumowaniem skończyło się na znalezieniu klienta: faktur model nie pobrał narzędziem, tylko podał dwie, których w systemie nie było, nr 123456 i 789012. Dane takie jak faktury model powinien pobierać narzędziami, które opisuje kolejna część.
Wywoływanie narzędzi (function calling)
Narzędzia to funkcje programu, o których wykonanie model może poprosić. Program opisuje je w polu tools w formacie OpenAI, model zwraca w polu tool_calls nazwę funkcji i argumenty, a program odsyła wynik w wiadomości z rolą tool. Zapytany o pogodę w Warszawie, z opisaną funkcją pogoda, Bielik zwrócił pogoda({"miasto": "Warszawa"}), także w trybie strumieniowym. Według SpeakLeash w teście τ²-bench, który symuluje obsługę klienta z użyciem narzędzi, wersja 3.1 osiąga wyniki o 16 do 45 punktów procentowych wyższe niż 3.0.
Trzy ustawienia wymagają uwagi:
- Wymuszone wywołanie (
tool_choice: "required") warto stosować tylko wtedy, gdy narzędzie jest naprawdę potrzebne. Zmuszony do wywołania przy zwykłym powitaniu, model wypełnił argumenty przykładem z opisu narzędzia i zapytał o pogodę albo godzinę w Krakowie („miasto, np. Kraków”). - Przy wyłączonych narzędziach (
tool_choice: "none") model odpowiada z własnej wiedzy. Zapytany wtedy o bieżącą pogodę, podał przybliżoną, zamiast napisać, że jej nie zna, więc pytania o bieżące dane lepiej zadawać z włączonymi narzędziami. - Zapas w
max_tokenschroni wywołania: wywołanie ucięte przez limit wraca jako tekst ze znacznikiem<tool_call>, a nie jako wywołanie.
Karta modelu radzi też sprawdzać argumenty wywołań przed użyciem, jak wszystkie dane z zewnątrz. Pojedyncze wywołania działają dobrze, a do zadania z kilku kroków potrzebny jest jeszcze odpowiedni prompt systemowy.
Prompt systemowy, który robi z Bielika agenta
Agent działa w pętli: wysyła rozmowę do modelu, wykonuje zlecone narzędzia i odsyła ich wyniki, aż model odpowie tekstem. Bielik wykonuje taką pracę dobrze, gdy prompt systemowy rozpisuje ją na kroki. Z takim promptem w każdej próbie, po polsku i po angielsku, poprawnie złożył zamówienie z zamiennikiem i podał limit hotelowy wraz z osobą akceptującą wyjazd, a zestawienie zaległych faktur, które testowaliśmy tylko po polsku, wykonał poprawnie we wszystkich pięciu próbach w konfiguracji naszej usługi. Każde z tych zadań zajęło od 2 do 7 sekund. Tak wyglądał, nieco skrócony, prompt do zamówień:
# Rola
Składasz zamówienia w systemie sklepu.

# Pojęcia
- Dostępny w całości: `available` co najmniej równe zamawianej ilości.
- Zamiennik: produkt, który `find_substitute` zwraca dla pozycji niedostępnej
  w całości; zastępuje całą ilość.

# Procedura
1. Dla każdej pozycji z polecenia: wywołaj `check_stock` z jej kodem (SKU).
2. Dla każdej pozycji niedostępnej w całości: wywołaj `find_substitute` z jej
   kodem, a potem `check_stock` z kodem zamiennika.
3. Wywołaj `place_order` z identyfikatorem klienta i pozycjami końcowymi.
4. Jeśli `place_order` zwróci błąd, przeczytaj komunikat, popraw to, czego
   wymaga, i wywołaj `place_order` jeszcze raz; najwyżej dwa razy.
5. Odpowiedz.

# Zasady
- Wywołuj jedno narzędzie naraz i czekaj na jego wynik.
- Nigdy nie wymyślaj danych: używaj tylko wyników narzędzi.
- Nie pisz, że coś zrobiłeś, jeśli narzędzie tego nie potwierdziło.
- Bez symboli zastępczych, takich jak [suma]: wpisuj prawdziwe wartości.
- Między wywołaniami narzędzi nie pisz tekstu: decyzje podejmuj w myślach
  i od razu wywołuj kolejne narzędzie. Jedyny tekst, jaki piszesz, to
  odpowiedź końcowa.

# Odpowiedź
- Numer zamówienia, zamówione pozycje z ilościami i cenami, każda zamiana i
  jej powód, każda zmiana ceny oraz suma z wyniku `place_order`.
Krótki prompt w rodzaju „Jesteś asystentem działu sprzedaży, sprawdzaj dane narzędziami” wystarcza większemu Arete 27B. Bielikowi nie mówi jednak, jak przejść od jednego kroku do następnego, i jego odpowiedzi rozmijają się wtedy z wynikami narzędzi:
- w skrzynce z wiadomościami od E-1 do E-6 poprosił o treść nieistniejącej
WIADOMOSC_001; - zapytany o limit hotelowy odpowiedział, że nie ma do tego narzędzi, choć je miał;
- napisał, że zapisał szkic e-maila, nie wywołując narzędzia do zapisu.
Prompt z procedurą ma kilka stałych cech:
- każdy krok przed odpowiedzią to jedno wywołanie narzędzia, a decyzja, na przykład „dla każdej pozycji niedostępnej w całości”, jest częścią kroku;
- zapytanie wysyła
temperature: 0iparallel_tool_calls: false; - argumenty są opisane słowami, bo zapis w rodzaju
zapisz_szkic(do: …)model przepisuje jako tekst, zamiast wywołać narzędzie; - prompt opisuje, co ma się znaleźć w odpowiedzi, ale nie daje gotowego szablonu, bo model wypełnia go dosłownie, razem z „Szanowna Pani/Szanowny Panie”.
Taki prompt jest szyty na miarę Bielika: Arete 27B z tym samym promptem w jednym zadaniu wpadł w pętlę. Procedurę najlepiej napisać samemu, bo te napisane przez Bielika i przez Arete 27B sprawdziły się gorzej niż napisana ręcznie. Jedna rzecz wymaga jednak narzędzia, nie promptu.
Obliczenia na datach i godzinach należą do narzędzi
Obliczenia na datach i godzinach warto powierzyć narzędziu, czyli zwykłej funkcji programu. W zadaniu umówienia godzinnego spotkania trzech osób Bielik z narzędziem find_meeting_time, które przecina kalendarze i zwraca najwcześniejszy wolny termin, rezerwował właściwą godzinę, 16:00-17:00, we wszystkich sześciu próbach, po polsku i po angielsku, w około 1,5 sekundy. Bez tego narzędzia poprawnie odczytywał kalendarze, ale przecięcie przedziałów liczył sam i rezerwował 10:30-11:30, choć Piotr był zajęty do 11:00, a Marek od 11:00. Podobnie w poprawnej poza tym odpowiedzi o politykę podróży napisał, że wyjazd od 2 do 6 grudnia trwa 4 dni, a nie 5, więc także liczenie dni między datami lepiej zostawić narzędziu.
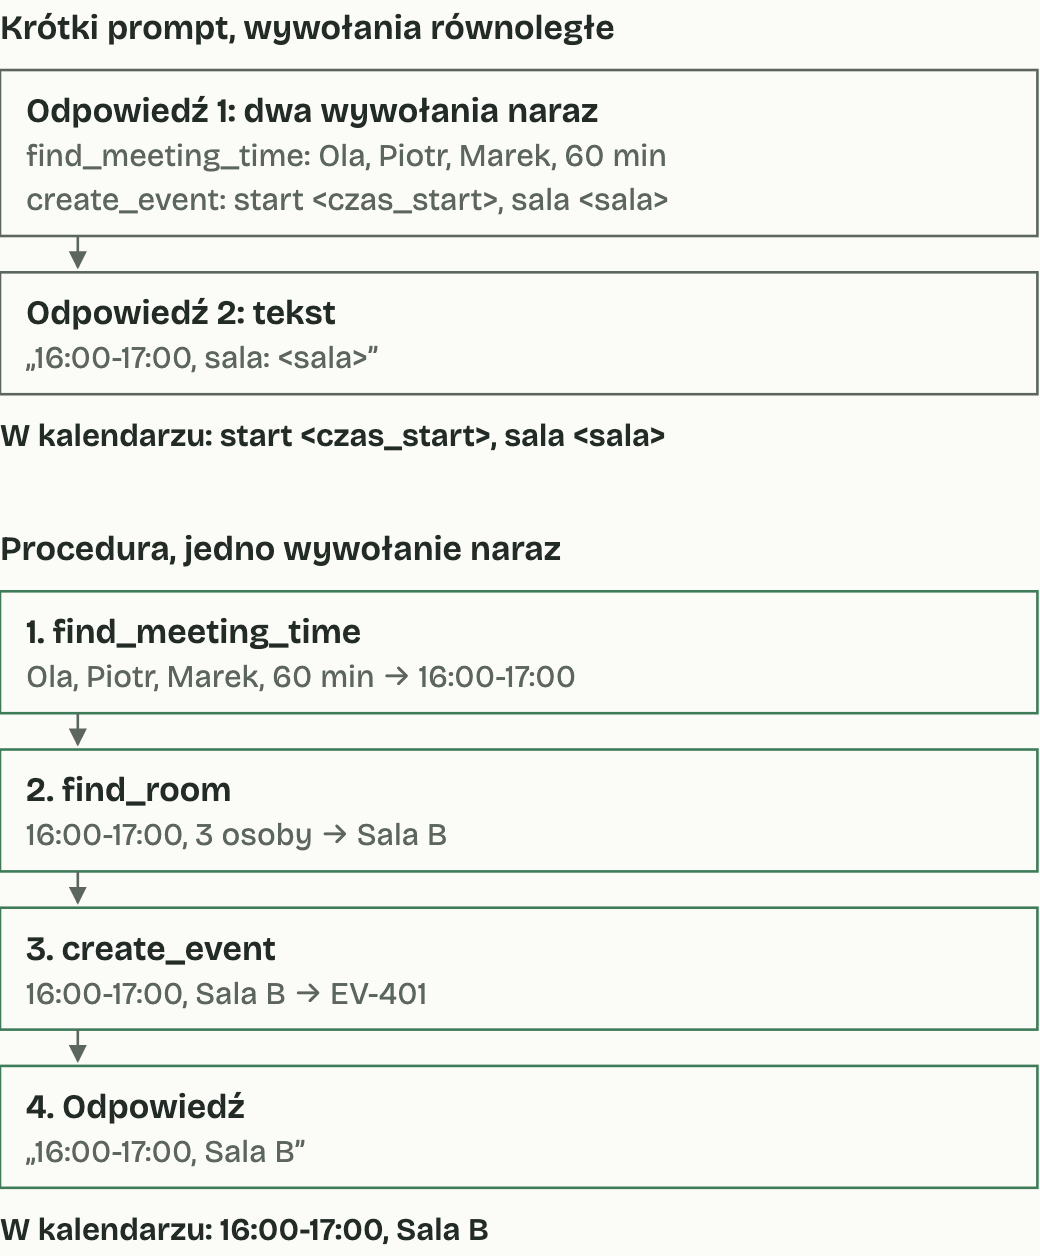
Rysunek pokazuje też, po co wyłączać równoległe wywołania (parallel_tool_calls: false). Gdy są dozwolone, model z krótkim promptem w jednej odpowiedzi prosi o wolny termin i od razu o rezerwację, zanim pozna wynik, więc rezerwacja dostaje godzinę <czas_start>. Z procedurą i jednym wywołaniem naraz każde narzędzie dostaje wynik poprzedniego. Z czytaniem długich tekstów Bielik radzi sobie natomiast bez pomocy.
Długie dokumenty do 32 tys. tokenów
Długi dokument, na przykład regulamin albo instrukcję, można wysłać w jednym zapytaniu razem z pytaniem: 30 tys. tokenów to ponad 30 stron tekstu. W naszym teście dokumentem był podręcznik firmy pełen podobnych numerów inwentarzowych, umów i nazwisk, z trzema faktami ukrytymi na 10, 50 i 90% długości. Bielik znalazł każdy z nich przy 4, 16 i 30 tys. tokenów, po polsku i po angielsku, a często wskazywał też paragraf. Zapytany o przedmiot, którego w podręczniku nie było, zawsze odpowiadał, że dokument tego nie podaje, zamiast podać numer z sąsiedniego akapitu.
Pierwsze pytanie o dokument długości 30 tys. tokenów dostało pierwszy token odpowiedzi po 3,9 s, kolejne pytania o ten sam dokument po 0,4-0,5 s, bo serwer zachowuje przeczytany początek zapytania. Stałą część, czyli prompt systemowy i dokument, warto więc umieszczać na początku, a pytanie na końcu. Program, który sprawdza odpowiedzi, powinien czytać je w całości: jedna odpowiedź po angielsku zaczęła się od stwierdzenia, że faktu w dokumencie nie ma, a dalej go podała. Tak Bielik działa w naszej usłudze, a kto uruchamia go u siebie, ma do ustawienia kilka rzeczy.
Bielik na własnym serwerze
Model można pobrać z serwisu Hugging Face i uruchomić na przykład w vLLM, programie, który udostępnia go przez takie samo API. Jak zbudować wokół modelu całe API z kluczami i rozliczeniami, opisujemy w artykule Jak zbudować API LLM na własnym sprzęcie. O jakości i szybkości zdecydowały u nas trzy ustawienia:
- Karta modelu zaleca parsery z repozytorium bielik-tools fundacji SpeakLeash. Wydzielają z odpowiedzi wywołania narzędzi i rozumowanie, i z nimi wszystkie sprawdzane funkcje API działały poprawnie. Z parserami wbudowanymi w vLLM cała odpowiedź potrafiła trafić do pola rozumowania, a tekst wracał pusty.
- Model pomocniczy Bielik DFlash2 podsuwa kolejne fragmenty odpowiedzi, a Bielik je sprawdza. Na karcie RTX 5090 przyspieszył odpowiedzi 2,6 raza po polsku, do około 290 tokenów na sekundę, i 1,7 raza po angielsku, do 190, przy jednym zapytaniu naraz.
- Wytyczne modelu zostawiliśmy włączone. Z nimi agent wykonywał całą procedurę, a bez nich po odczytaniu danych przestawał.
Sprawdziliśmy to na jednej karcie i w jednej konfiguracji, a na innym sprzęcie warto to zmierzyć, jak wszystkie obserwacje z naszych testów.
Co pokazują nasze testy, a czego nie
Kilka testów nie mówi wszystkiego o modelu, dlatego warto wiedzieć, co obejmowały nasze. Było to sześć niewielkich zadań, które napisaliśmy sami, ze zmyślonymi danymi, po polsku i, poza zestawieniem faktur, po angielsku: zestawienie zaległych faktur, pytanie o politykę podróży, przegląd skrzynki zgłoszeń, umówienie spotkania, zamówienie z zamiennikiem i wyszukiwanie w długim dokumencie. Większość powtarzaliśmy od trzech do pięciu razy. Wyniki pokazują, jak Bielik zachowuje się przy danym sposobie zadawania pytań, i że to zachowanie się powtarza.
Z procedurą i narzędziem do obliczeń cztery z pięciu zadań agenta wykonał w każdej próbie poprawnie we wszystkich sprawdzanych punktach, a jedyną pomyłką była opisana wyżej liczba dni podróży. W przeglądzie skrzynki zgłoszeń po polsku utworzył wszystkie zgłoszenia poprawnie, ale zakończył bez podsumowania i bez wymienienia nadawcy spoza bazy klientów, a po angielsku nadał też zwykłej usterce wysoki priorytet. Nie jest to benchmark: inne zadania mogą wypaść inaczej, a ogólne możliwości modelu opisują testy fundacji SpeakLeash na karcie modelu.
Od czego zacząć
Do czatu i pytań o dokumenty wystarczy pierwsze zapytanie, bo Bielik odpowiada od razu, po polsku, i pewnie znajduje fakty w długich tekstach. Agent potrzebuje procedury i narzędzi do obliczeń, a kto uruchamia model u siebie, powinien zacząć od parserów SpeakLeash i modelu DFlash2. Pierwsze kroki:
- Zalogować się w serwisie Blixild AI, gdzie od razu dostępne są klucz API i 1 USD środków na start.
- Wysłać zapytanie z przykładu powyżej, z modelem
bielik-11b-v3.1. - Dla agenta napisać prompt z procedurą, wzorując się na przykładzie z zamówieniem, i wysyłać
temperature: 0orazparallel_tool_calls: false. - Obliczenia na datach i godzinach przekazać narzędziom, czyli funkcjom programu.
- Sprawdzić agenta na własnych zadaniach, każde kilka razy, bo pojedyncza próba niewiele mówi.
Bielik 11B v3.1 działa w Blixild AI na naszej karcie RTX 5090 w Polsce, w cenie 0,20 USD za milion tokenów wejścia i 0,50 USD za milion tokenów wyjścia. Model, który ma działać w siedzibie klienta lub na jego koncie w chmurze, uruchamiamy i utrzymujemy w ramach naszego hostingu AI.
Źródła
- Bielik.ai (2026). Premiera modeli Bielik 11B v3.1, DFlash i rodziny Bielik-One. https://www.bielik.ai/blog/premiera-modeli-bielik-11b-v31-dflash-i-rodziny-bielik-one
- SpeakLeash (2026). Bielik-11B-v3.1-Instruct, karta modelu. https://huggingface.co/speakleash/Bielik-11B-v3.1-Instruct
- SpeakLeash (2026). Bielik-11B-v3.1-DFlash2-FP8-Dynamic, karta modelu. https://huggingface.co/speakleash/Bielik-11B-v3.1-DFlash2-FP8-Dynamic
- SpeakLeash (2026). bielik-tools, repozytorium. https://github.com/speakleash/bielik-tools
- Fundacja SpeakLeash (2025). Regulamin korzystania z modeli, wersja 1.1 z 31 lipca 2025 r. https://www.bielik.ai/regulamin