Każda wiadomość do obsługi klienta to klient, który czeka na pomoc, a czeka dłużej, gdy wiadomość trafi do niewłaściwego zespołu. Program może w chwili jej nadejścia odpowiedzieć na dwa pytania: który zespół ma się nią zająć i czy klient nie został odcięty od usługi.
Na karcie graficznej H200 model generatywny o 27 miliardach parametrów potrzebował na to około 150 milisekund: około 90 na przeczytanie wiadomości z instrukcją i 60 na napisanie krótkiej odpowiedzi token po tokenie. basal, model decyzyjny o 4,5 miliarda parametrów, na tej samej karcie odpowiedział na oba pytania w około 20 milisekund i podał prawdopodobieństwo dla każdej opcji. Program, który podejmuje wiele takich małych decyzji o tekstach, na przykład kieruje wiadomości, sprawdza regułę albo wybiera następny krok agenta, może dostać każdą odpowiedź w jednym przebiegu małego modelu, za ułamek pracy obliczeniowej, i widzieć, na ile model jest pewny.
Ten poradnik pokazuje, jak korzystać z modelu basal LLM przez API i kiedy oszczędza on czas i moc obliczeniową, w porównaniu z trzema modelami generatywnymi na tych samych 38 decyzjach. Najważniejsze wnioski:
- na tej samej karcie basal odpowiadał w czasie od jednej siódmej do jednej dziesiątej czasu modelu generatywnego 27B, przy od jednej szóstej do jednej dziewiątej jego pracy obliczeniowej;
- trafnie rozstrzygnął 35 z 38 decyzji, a dwa modele generatywne 27B wszystkie 38, przy czym dwa jego błędy wzięły się z jednego długo sformułowanego pytania;
- o dobrym kierowaniu wiadomości decyduje krótki opis każdej opcji;
- daty i kwoty najlepiej obliczać w kodzie i podawać modelowi jako fakty;
- przez API płaci się tylko za tekst, który model czyta, bo sam niczego nie pisze.
Programiści, którzy kierują albo klasyfikują teksty, znajdą tu pierwsze zapytanie i sposób dobrego zadawania pytań. Ci, którzy budują agentów, zobaczą, jak basal wybiera następny krok w jednym przebiegu, a zespoły uruchamiające własne modele, czego wymaga udostępnienie go przez bramę. Kolejno: czym jest model decyzyjny, pierwsze zapytanie, porównanie z modelami generatywnymi, jak pytać model basal, czego nauczyło nas jego udostępnianie i od czego zacząć. O Bieliku 11B v3.1, modelu generatywnym stworzonym z myślą o języku polskim, piszemy w osobnym poradniku.
Model decyzyjny odpowiada w jednym przebiegu, z prawdopodobieństwem dla każdej opcji
basal to rodzina otwartych modeli decyzyjnych dla języka polskiego i angielskiego autorstwa Remigiusza Kinasa. Jej modele 2.0 powstały przez dalszy trening Bielika v3 i są opublikowane na licencji Apache 2.0. Rodzina nawiązuje do modeli decyzyjnych typu System 1, takich jak Jev firmy TypeSafe, szybkich i intuicyjnych zamiast rozważnych, i przyjmuje zapytania w formacie System One, którego używa Jev. Udostępniamy dwa z tych modeli: basal-2.0-4.5b, model główny, i basal-2.0-mini o 1,5 miliarda parametrów, najszybszy. Wydanie 2.8.1 oprogramowania, które je obsługuje, ukazało się 15 listopada 2026 r.
Zapytanie zawiera stan, czyli tekst, którego dotyczy decyzja, i nazwane pytania o ten tekst. W naszym API pytanie jest jednego z trzech rodzajów: tak lub nie, wybór spośród 2 do 255 opcji albo poziom na skali. Sam basal zna ich więcej, do czego wracamy w części o udostępnianiu modelu. Model czyta tekst i pytania raz i dla każdego pytania zwraca prawdopodobieństwo każdej dopuszczalnej odpowiedzi oraz odpowiedź, którą wybiera. Niczego nie pisze, więc jego odpowiedź nie może wyjść poza podane opcje, a kilka pytań o jeden tekst wymaga jednego przebiegu.
Prawdopodobieństwa są skalibrowane: spośród wielu decyzji te, które model podał z pewnością 0,9, mają być trafne mniej więcej dziewięć razy na dziesięć. Dzięki temu można ustalić próg: decyzje powyżej niego idą dalej same, a pozostałe trafiają do człowieka.
basal nie pisze tekstu ani nie podaje uzasadnienia: do streszczenia czy wyjaśnienia nadal potrzebny jest model generatywny. Wybiera też odpowiedź na każde pytanie, nawet takie, którego tekst nie rozstrzyga, chyba że wśród opcji jest na przykład „nie da się ustalić”, a sygnałem tego jest niska pewność. Co basal zwraca, najłatwiej zobaczyć na jednym zapytaniu.
Pierwsze zapytanie do modelu basal LLM przez API
Zapytanie trafia pod api.blixild.com, adres naszego API, z kluczem dostępnym w panelu po zalogowaniu w serwisie Blixild AI. To zapytanie zadaje modelowi basal-2.0-4.5b dwa pytania o jedną wiadomość do obsługi klienta: który z pięciu zespołów ma się nią zająć i czy usługa nie działa dla klienta. Każdy zespół ma krótki opis, a "option_keys": "hide" pokazuje modelowi tylko opisy, bez kluczy.
import requests

zespoly = {
    "platnosci": "Płatności, doładowania i faktury",
    "techniczne": "Problemy techniczne z API: błędy, przerwy w działaniu",
    "konto": "Konto i klucze API: logowanie, wyciek klucza",
    "sprzedaz": "Oferta, ceny, umowy i większe zamówienia",
    "inne": "Spam i sprawy niezwiązane z usługą",
}
wiadomosc = ("Dzień dobry, od rana każde zapytanie do bielik-11b-v3.1 "
             "zwraca błąd 502. Nasza aplikacja stoi. Proszę o pilną pomoc.")
odpowiedz = requests.post(
    "https://api.blixild.com/v1/systemone",
    headers={"Authorization": "Bearer KLUCZ_API"},
    json={
        "model": "basal-2.0-4.5b",
        "state": wiadomosc,
        "questions": {
            "zespol": {"type": "choice", "criteria": zespoly,
                       "instructions": "Który zespół ma się tym zająć?",
                       "option_keys": "hide"},
            "awaria": {"type": "noul",
                       "instructions": "Czy usługa nie działa dla klienta?"},
        },
    },
).json()
print(odpowiedz["answers"])
print(odpowiedz["usage"]["input_tokens"])
Odpowiedzi, skrócone i z zaokrąglonymi prawdopodobieństwami:
{"zespol": {"choice": "techniczne", "confidence": 0.93,
            "probabilities": {"techniczne": 0.93, "konto": 0.02,
                              "platnosci": 0.02, "inne": 0.01,
                              "sprzedaz": 0.01}},
 "awaria": {"noul": 0.68, "probabilities": {"true": 0.68, "false": 0.32}}}
basal kieruje wiadomość do zespołu technicznego z pewnością 0,93. Na to, że usługa nie działa, wskazuje z prawdopodobieństwem 0,68, czyli trafnie, choć mniej pewnie. Obie odpowiedzi dał jeden przebieg przez wiadomość, który przeczytał 278 tokenów i żadnego nie napisał, więc przy naszej cenie modelu basal-2.0-4.5b, 0,10 USD za milion tokenów wejścia, tysiąc takich wiadomości kosztuje około 2,8 centa.
To format System One modelu Jev, więc zapytanie napisane dla API Jev, z pytaniami tak/nie, pytaniami wyboru i oceny, działa z modelem basal po zmianie adresu, klucza i nazwy modelu. Ten sam model odpowiada też pod /v1/decisions w formacie Decisions firmy OpenAI, z polem input i listą pytań typu predicate, choice i score: nasze API tłumaczy jeden format na drugi, więc kod napisany dla API Decisions firmy OpenAI, który wysyła sam tekst, wymaga tych samych trzech zmian.
Przez nasze API basal odpowiada tylko na te trzy rodzaje pytań. Pozostałe, takie jak kilka etykiet naraz, wypełnianie pól na podstawie dokumentu czy wybór następnego narzędzia agenta wprost z definicji narzędzi, wymagają własnego serwera z modelem basal, podobnie jak ustawienia całego zapytania, na przykład język, które nasze API pomija. Czy programowi opłaca się wysyłać je do modelu basal zamiast do modelu generatywnego, zależy od tego, ile każdy z nich kosztuje czasu, pracy i pieniędzy.
basal potrzebuje ułamka czasu i pracy modelu generatywnego 27B
Model generatywny może podejmować te same decyzje, a wiele programów już go o nie pyta. Żeby sprawdzić, co oszczędza basal, wysłaliśmy te same 24 zapytania do modelu basal i do trzech modeli generatywnych, które udostępniamy: 14 wiadomości do obsługi klienta, 11 po polsku i 3 po angielsku, każdą z pytaniem o zespół i o to, czy usługa nie działa, i 10 polskich wiadomości do asystenta sklepu, każdą z pytaniem o następny krok: jedno z sześciu narzędzi, odpowiedź albo pytanie zwrotne do klienta. Razem to 38 decyzji ze znanymi odpowiedziami.
Modele generatywne, Bielik 11B v3.1, Qwen3.8-27B i Arete 27B, dostały te same opisy opcji w pełnej instrukcji, format JSON dopuszczający tylko te opcje i wyłączone myślenie. Zapytania szły po jednym. Modele działają na różnych kartach, basal i Qwen na H200, Bielik na RTX 5090, a Arete na RTX 3090, przez co czas zmierzony na jednej karcie niewiele mówi o innej.
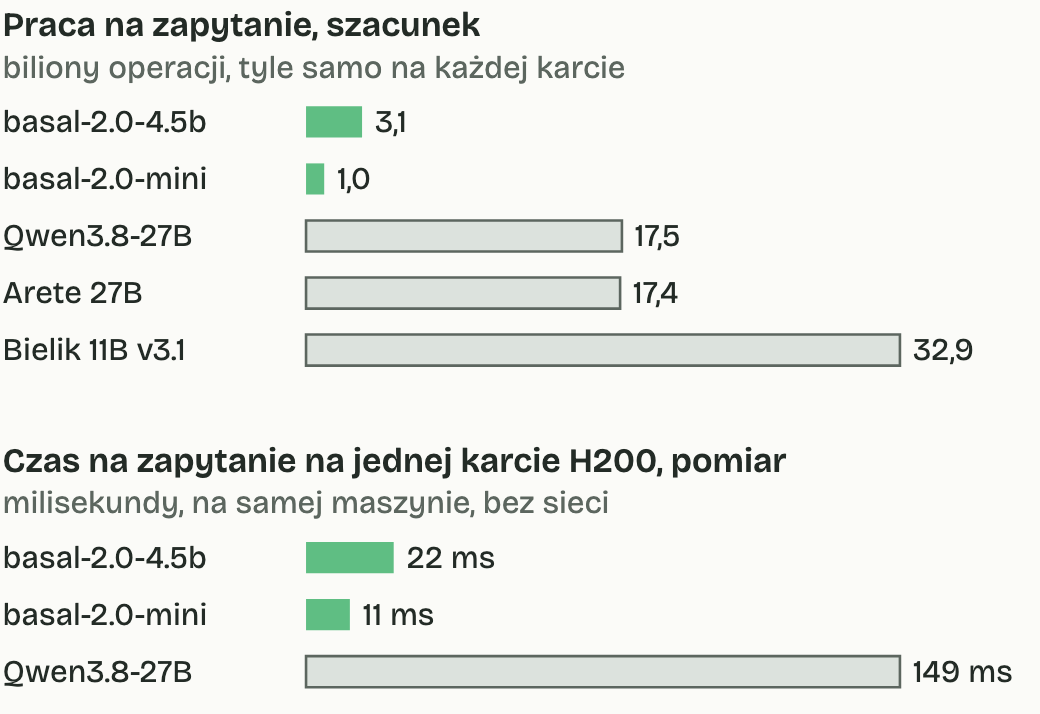
Dlatego porównanie używa dwóch miar. Czas porównujemy tylko między modelami na tej samej karcie i mierzymy go na samej maszynie, więc nie wlicza się do niego sieć. Pracę obliczeniową zapytania szacujemy jako dwukrotność liczby parametrów modelu na każdy przeczytany lub napisany token, a to przybliżenie obowiązuje na każdej karcie.
| Model | Trafne, z 38 | Tokeny wejścia / wyjścia na wiadomość | Za 1000 wiadomości, nasze ceny |
|---|---|---|---|
| basal-2.0-4.5b | 35 | 342 / 0 | 0,034 USD |
| basal-2.0-mini | 34 | 342 / 0 | 0,017 USD |
| Qwen3.8-27B | 38 | 310 / 13 | 0,082 USD |
| Arete 27B | 38 | 310 / 13 | 0,051 USD |
| Bielik 11B v3.1 | 36 | 1481 / 14 | 0,30 USD |
Na maszynie z kartą H200 basal-2.0-4.5b odpowiadał na dwa pytania o wiadomość w około 20 milisekund, a następny krok asystenta sklepu wybierał w około 10, podczas gdy Qwen3.8-27B potrzebował około 150 i 120. To od jednej siódmej do jednej dziesiątej czasu przy od jednej szóstej do jednej dziewiątej szacowanej pracy. Ze 150 milisekund Qwena na wiadomość około 90 zajęło przeczytanie jej z instrukcją, a 60 napisanie odpowiedzi z 13 tokenów, podczas gdy basal czyta raz i niczego nie pisze.
Dwa modele generatywne 27B rozstrzygnęły trafnie wszystkie 38 decyzji, Bielik 36, a basal-2.0-4.5b 35. Dwa błędy modelu basal wzięły się z jednego pytania, czy usługa nie działa, zadanego w długim brzmieniu z opisem każdej odpowiedzi. Gdy we wcześniejszych testach zadaliśmy je krótko, ten sam model trafił we wszystkich 14 wiadomościach. Trzeci błąd dotyczył uszkodzonego zamówienia z kwotą zwrotu, które basal skierował do działu reklamacji zamiast do zwrotu pieniędzy. Wersja mini pomyliła się cztery razy, w tym dwa razy przy następnym kroku asystenta sklepu.
Przy cenach Blixild AI decyzja kosztuje z modelem basal mniej niż z którymkolwiek z trzech modeli generatywnych: 3,4 centa za tysiąc wiadomości, wobec 5,1 dla Arete, 8,2 dla Qwena i 30 dla Bielika. Różnica do Arete jest niewielka, bo Arete czyta mniej więcej tyle samo tokenów i pisze niewiele. Do Bielika jest duża, bo jego wbudowane wytyczne dodają do każdego zapytania około tysiąca tokenów, a jego cena za token wejścia jest dwa razy wyższa niż modelu basal. Te ceny są nasze, ustalone dla każdego modelu, a nie cechą samych modeli.
Porównanie ma swoje granice. Decyzji było 38, w dwóch rodzajach zadań, czyli niewiele, brzmienie pytań i opisy były nasze, a każdy model generatywny mógłby wypaść lepiej z promptem dopasowanym do niego. Praca obliczeniowa to szacunek, który pomija precyzję liczb w każdym modelu, a czas mierzyliśmy po jednym zapytaniu na samej maszynie, nie przy pełnym obciążeniu i bez sieci, na którą program też czeka. Dwa z trzech błędów modelu basal wynikały ze sposobu zadania pytania, więc to od niego zależy, jak trafnie basal rozstrzyga.
Jak pytać model basal, żeby dobrze rozstrzygał
Model decyzyjny czyta tylko to, co dostaje w zapytaniu, więc większość jego błędów bierze się ze sposobu zadania pytania. Dokumentacja modelu basal i nasze testy wskazują te same zasady:
- każda opcja potrzebuje krótkiego opisu: kierowanie 14 wiadomości po samych nazwach zespołów, z pytaniem po angielsku, dało 6 trafień, a z opisem każdego zespołu i pytaniem po polsku, jak większość wiadomości, wszystkie 14;
- pytanie tak/nie powinno być krótkie i dotyczyć jednego warunku: zapytany krótko, czy usługa nie działa, basal-2.0-4.5b trafił we wszystkich 14 wiadomościach, a w dłuższym brzmieniu z porównania pomylił się dwa razy;
- wszystkie pytania o jeden tekst warto zadać w jednym zapytaniu, które czyta tekst raz i daje te same odpowiedzi szybciej;
- reguły i fakty potrzebne do decyzji należy umieścić w tekście, na przykład termin zwrotu albo dzisiejszą datę, a pytanie pisać w języku tekstu, za którym basal podąża;
- gdy tekst może nie zawierać odpowiedzi, warto dodać opcję w rodzaju „nie da się ustalić”.
Daty i kwoty to jego słaba strona. Na dwunastu polskich regułach dotyczących terminów i kwot, na przykład czy faktura jest po terminie, model 4.5B trafił osiem razy przy zapisie wprost i dziewięć, gdy datę albo sumę obliczyliśmy wcześniej. Regułę w rodzaju „po terminie” najlepiej rozstrzygać w kodzie, a model basal niech czyta tekst wokół niej.
Pewność decyduje o tym, co idzie dalej samo. Pytanie z "max_error": 0.05 wraca z "abstain": true, gdy basal jest mniej pewny niż jego próg dla 5 procent błędów, a nasze API przekazuje to ustawienie dalej. W przykładzie wyżej odpowiedź o zespole, z pewnością 0,93, idzie dalej sama, a odpowiedź o awarii, z pewnością 0,68, czeka na człowieka, choć jest trafna. Domyślny próg jest ostrożny: na rodzajach pytań, na których go nie trenowano, model 4.5B rozstrzyga sam mniej więcej jedną trzecią decyzji. Próg ustalony na własnych, oznaczonych tekstach, we własnym kodzie przy naszym API albo narzędziem kalibracji modelu basal na własnym serwerze, dopasowuje pewność do własnych danych. Według dokumentacji modelu do celu 5 procent zwykle wystarcza kilkaset oznaczonych decyzji.
Wersja mini odpowiada w mniej więcej połowie czasu modelu 4.5B i za połowę ceny, a trafiła w 34 z 38 decyzji wobec 35 modelu 4.5B. Czyta najwyżej 8192 tokeny, model 4.5B 32 768, a dłuższy tekst skraca w środku. Zespół, który uruchamia model basal na własnym serwerze, ma większy wybór, ale też kilka spraw do ustalenia.
Udostępnianie modelu basal przez API zgodne z OpenAI
Taki zespół może chcieć udostępniać model basal przez to samo API, z tymi samymi kluczami i rozliczeniami co modele generatywne. My robimy to przez LiteLLM, otwartą bramę, która daje wielu modelom jedno API w stylu OpenAI, a pięć wniosków z tej pracy dotyczy każdego, kto robi to samo:
- LiteLLM obsługuje modele decyzyjne pod dwiema własnymi ścieżkami,
/v1/systemonei/v1/decisions, ze zwykłymi kluczami, budżetami i limitami zapytań, a ścieżka czatu je odrzuca. Odpowiedzi modeli decyzyjnych LiteLLM nie przesyła strumieniowo; - przekazuje pytania tak/nie, pytania wyboru i oceny razem z ich własnymi polami, takimi jak
option_keysimax_error, a pozostałe rodzaje pytań modelu basal odrzuca, zanim model je zobaczy, przy czym ustawienia całego zapytania, takie jak język i obliczane fakty modelu basal, do modelu nie docierają; - model decyzyjny niczego nie pisze, więc potrzebuje tylko ceny za token wejścia i oznaczenia w ustawieniach jako model decyzyjny, bo inaczej kontrola stanu w LiteLLM wysyła mu zapytanie czatu, na które nie umie odpowiedzieć;
- dostawca TypeSafe w LiteLLM, przygotowany dla modelu Jev, bez ustawionego adresu wysyła zapytania do usługi TypeSafe, więc pomyłka w ustawieniach przesłałaby teksty klientów firmie trzeciej, a dostawca Strands Decider, przygotowany dla modeli decyzyjnych uruchamianych u siebie, nie ma domyślnego adresu i w takiej sytuacji zgłasza błąd;
- tryb fast modelu basal kompiluje model przy starcie serwera, co trwa kilka minut i wymaga na maszynie kompilatora C i plików nagłówkowych Pythona, a w naszych pomiarach odpowiadał od 1,5 do 2 razy szybciej, z prawdopodobieństwami różniącymi się najwyżej o 0,04 od wersji bez kompilacji.
Na własnym serwerze dostępne są pozostałe rodzaje pytań modelu basal, jego obliczane fakty dla polskich dat i kwot oraz narzędzie kalibracji. Przez nasze API nie są, więc punkt wyjścia zależy od tego, czego program potrzebuje od modelu basal.
Od czego zacząć decyzje z modelem basal
Przy kierowaniu i klasyfikowaniu tekstów basal się opłaca, gdy decyzji jest wiele i są krótkie, a opcje da się opisać jednym zdaniem. W agencie wybiera następny krok w jednym przebiegu, a argumenty wywołania narzędzia zostawia modelowi generatywnemu albo kodowi. Zespołowi, który uruchamia własne modele, w pierwszej kolejności przydadzą się ścieżki bramy, dostawca bez domyślnego adresu i tryb z kompilacją. Pierwsze kroki:
- Spisać decyzje, które program podejmuje o tekstach, i dla każdej opcji napisać krótki opis.
- Zalogować się w serwisie Blixild AI, gdzie od razu dostępne są klucz API i 1 USD środków na start.
- Wysłać od 20 do 50 własnych tekstów o znanych odpowiedziach do modeli basal-2.0-4.5b i basal-2.0-mini, jak w przykładzie powyżej.
- Oznaczać na bieżąco kolejne kilkaset tekstów, wybrać na ich podstawie próg pewności albo ustawić
max_error, a decyzje poniżej progu przekazywać człowiekowi. - Przenieść daty, kwoty i inne obliczenia do kodu i podawać modelowi basal wyniki.
Modele basal-2.0-4.5b i basal-2.0-mini działają w Blixild AI na naszej karcie H200 w Polsce, w cenie 0,10 i 0,05 USD za milion tokenów wejścia, bez opłat za wyjście. Modele decyzyjne i modele generatywne, które mają działać w siedzibie klienta lub na jego koncie w chmurze, uruchamiamy i utrzymujemy w ramach naszego hostingu AI.
Pojęcia
- LLM
- LLM to duży model językowy, wytrenowany na dużych zbiorach tekstu. Większość pisze odpowiedź token po tokenie.
- Parametry
- Parametry to liczby, których model uczy się w trakcie treningu. Ich liczba określa wielkość modelu: im więcej parametrów, tym więcej pracy przy każdym czytanym i pisanym tokenie.
- Token
- Token to fragment słowa. Modele czytają i piszą tokeny, a cenniki API liczą opłaty od tokenów.
Źródła
- Kinas, R. (2026). basal 2.8.1, README. https://github.com/rkinas/basal/blob/v2.8.1/README.md
- Kinas, R. (2026). basal 2.8.1, API. https://github.com/rkinas/basal/blob/v2.8.1/docs/API.md
- Kinas, R. (2026). basal 2.8.1, rodzaje pytań. https://github.com/rkinas/basal/blob/v2.8.1/docs/QUESTION_TYPES.md
- Kinas, R. (2026). basal 2.8.1, kalibracja na własnych danych. https://github.com/rkinas/basal/blob/v2.8.1/docs/CALIBRATION.md
- Kinas, R. (2026). basal-2.0-4.5B, karta modelu. https://huggingface.co/Remek/basal-2.0-4.5B
- LiteLLM (2026). /v1/decisions and /v1/systemone. https://docs.litellm.ai/docs/decisions
- OpenAI (2026). Decisions API, przewodnik. https://developers.openai.com/api/docs/guides/decisions